[Paper Review] UMM Transferability
[논문 리뷰] Transferability Between Understanding and Generation in Unified Multimodal Models
Transferability Between Understanding and Generation in Unified Multimodal Models
Jiwon Kang, Heeji Yoon et al.
ECCV 2026
[arXiv] [Github] [Project Page]
이 글의 본문·수치·그림은 arXiv v1을 기준으로 정리한다. 학회 정보는 공식 프로젝트 페이지와 arXiv의 발표 정보를 확인했다.
Background
Unified Multimodal Models
이미지 이해와 이미지 생성은 보통 서로 다른 모델의 역할이었다. VLM은 이미지에서 정보를 읽어 텍스트로 답하고, T2I 모델은 텍스트 조건을 만족하는 이미지를 만든다.
Unified Multimodal Model(UMM)은 이 두 task를 하나의 모델 안에서 지원한다. 예를 들어 같은 모델에 사진을 넣고 “컵이 몇 개 있는가?”를 물을 수도 있고, “컵 다섯 개가 있는 사진”을 생성하도록 요청할 수도 있다.
다만 두 task를 지원한다는 사실만으로 두 task가 같은 지식을 사용한다고 볼 수는 없다. 하나의 시스템 안에서도 이미지 입력 경로, transformer, 출력 모듈을 얼마나 공유하는지는 다르기 때문이다.
또한 여기서 understanding은 이미지에 관한 질문에 답하는 task를 뜻한다. 답변 자체가 텍스트 생성으로 구현되더라도, 이 논문에서 말하는 generation은 이미지 생성을 가리킨다.
Semantic Encoder와 Image Tokenizer
UMM의 공유 정도를 이해하려면 이미지가 어떤 representation으로 들어가는지부터 봐야 한다.
- CLIP·SigLIP 계열 encoder: 이미지와 텍스트의 의미를 정렬하는 학습을 거친다. 이미지의 내용을 언어로 설명하거나 reasoning하는 데 유용한 feature를 제공한다.
- 이미지 재구성용 autoencoder·tokenizer: 이미지를 latent 또는 discrete token으로 압축하고, decoder가 이를 다시 이미지로 복원한다. 이미지 생성 모델은 이 공간에서 출력을 만든다.
이 둘은 같은 이미지를 보더라도 학습 목적이 다르다. 전자는 언어와 연결되는 의미에, 후자는 재구성 가능한 시각 정보에 학습 신호를 둔다. 자세한 대조학습 배경은 SigLIP 리뷰와 연결된다.
때문에 understanding용 encoder와 generation용 tokenizer를 분리하는 설계가 가능하다. 각 task에 알맞은 입력을 줄 수 있지만, 두 task가 서로 다른 시각 표현을 통해 backbone에 접근한다는 차이가 생긴다.
동일한 transformer를 통과한다는 것과 동일한 이미지 표현을 사용한다는 것은 별개의 공유 조건이다. 이 논문은 이 두 조건을 함께 살펴본다.
Autoregressive Generation과 Discrete Diffusion
이미지 token을 생성하는 방식도 모든 UMM에서 같지 않다.
Autoregressive 모델은 앞서 생성한 token을 조건으로 다음 이미지 token을 순차적으로 예측한다. Discrete diffusion 모델은 가려지거나 손상된 discrete token을 반복적으로 복원한다. Continuous diffusion은 연속 latent에서 denoising을 수행한다.
주요 실험 모델인 Lumina-DiMOO는 공유 transformer와 통합 이미지 tokenizer를 사용하는 discrete diffusion 모델이다. 이미지 이해에서는 이미지 token을 조건으로 텍스트 출력을 복원하고, 이미지 생성에서는 텍스트를 조건으로 이미지 token을 복원한다.
즉, 입력과 예측 대상은 바뀌지만 동일한 backbone과 이미지 token 체계를 활용한다. 여기서 이미지 생성은 pixel에 직접 Gaussian noise를 더하는 일반적인 연속 diffusion과 구별해야 한다.
Capability-level Transferability
모델에 generation 학습을 추가한 후 일반 VQA 점수가 올랐다고 하자. 이 결과만으로는 이미지 생성 과정에서 배운 어떤 능력이 understanding으로 전달되었는지 알기 어렵다. 데이터가 늘거나 regularization 효과가 생겨도 점수가 바뀔 수 있다.
이 논문은 하나의 능력을 한쪽 task에서만 추가 학습한 뒤, 다른 쪽 task에서도 같은 능력이 좋아지는가를 묻는다.
예를 들어 counting understanding으로 “사진 속 개가 여섯 마리”라고 답하도록 fine-tuning한다. 이후 counting generation을 추가 학습하지 않은 상태에서 “개 여섯 마리”를 생성하는 정확도가 높아지는지 확인한다. 이를 understanding-to-generation transfer라고 부른다.
이하 표기에서 화살표 왼쪽은 추가 학습한 task, 오른쪽은 평가한 task다.
| 표기 | 추가 학습 | 평가 | 확인하는 효과 |
|---|---|---|---|
| $\mathrm{und}\rightarrow\mathrm{gen}$ | 이미지 이해 | 이미지 생성 | 이해에서 생성으로 전달 |
| $\mathrm{gen}\rightarrow\mathrm{und}$ | 이미지 생성 | 이미지 이해 | 생성에서 이해로 전달 |
| $\mathrm{gen}\rightarrow\mathrm{gen}$ | 이미지 생성 | 이미지 생성 | 생성 task의 직접 학습 |
| $\mathrm{und}\rightarrow\mathrm{und}$ | 이미지 이해 | 이미지 이해 | 이해 task의 직접 학습 |
중요한 전제는 이미 두 task를 학습한 pretrained UMM에 대한 post-training 실험이라는 점이다. 처음부터 이미지 생성 supervision 없이 생성 능력을 얻는다는 뜻은 아니다. 추가 학습에서 평가 대상 task의 직접 supervision을 주지 않았다는 의미다.
Introduction
이미지 생성 모델이 개수나 공간 배치를 자주 틀린다면 해당 능력을 가진 이미지·prompt pair로 generation을 fine-tuning하는 방법을 생각할 수 있다.
그런데 능력 학습에 적합한 데이터가 좋은 사진으로만 구성되어 있지는 않다. 예를 들어 공간 관계를 명확하게 가르치려고 두 객체 사진을 단색 배경에 붙여 만든 데이터는 위치 label을 쉽게 제공하지만, 자연스러운 이미지 분포와는 차이가 있다.
이 데이터를 생성 목표로 직접 학습하면 원하는 배치는 배우면서 합성 데이터의 외형까지 따라갈 수 있다. 기존 generation의 다양성이나 시각 품질을 유지하면서 능력만 보강하려는 목적과 충돌한다.
논문은 여기서 UMM의 공유 구조를 활용한다. 같은 데이터를 이미지 생성의 정답으로 쓰기보다, 이미지에서 개수나 위치를 읽는 understanding supervision으로 사용한다. 학습된 능력이 generation에 전달된다면 원래 이미지 분포를 덜 바꾸면서 원하는 능력을 보강할 수 있다는 것이다.
Goal
UMM에서 understanding과 generation 사이에 특정 능력의 전달이 존재하는지, 그 전달이 모델 구조와 능력의 종류에 따라 어떻게 달라지는지 확인한다. 나아가 전달 현상을 generation post-training에 활용할 수 있는지 검증한다.
Motivation
- 일반 benchmark의 종합 점수 변화만으로는 동일한 능력이 다른 task로 전달되었는지 분리하기 어렵다.
- UMM마다 backbone과 시각 representation의 공유 정도가 다르므로, 하나의 모델에서 관찰한 전달을 모든 UMM에 일반화할 수 없다.
- 능력에 특화된 데이터로 generation을 직접 학습하면 데이터 외형에 대한 distribution shift가 생길 수 있다.
Contributions
- 한 능력을 한쪽 task에서만 학습하고 다른 task에서 평가하는 capability-level transferability 실험을 구성한다.
- 네 가지 대표 구조를 비교하여 공유 transformer와 통합 이미지 encoder를 사용하는 모델에서 가장 강한 양방향 전달을 관찰한다.
- Counting, spatial relation, text recognition/generation에서 understanding 학습을 통한 생성 능력 보강을 검증한다. 전달 방향, joint training, LoRA rank와 일반 능력 유지도 분석한다.
이 논문의 중심은 새로운 UMM architecture나 loss를 제안하는 데 있지 않다. 기존 UMM에 개입하는 실험을 통해 전달 조건을 분석하고, 이를 학습 전략으로 이용하는 데 있다.
Method
Architecture: 무엇을 공유하는가
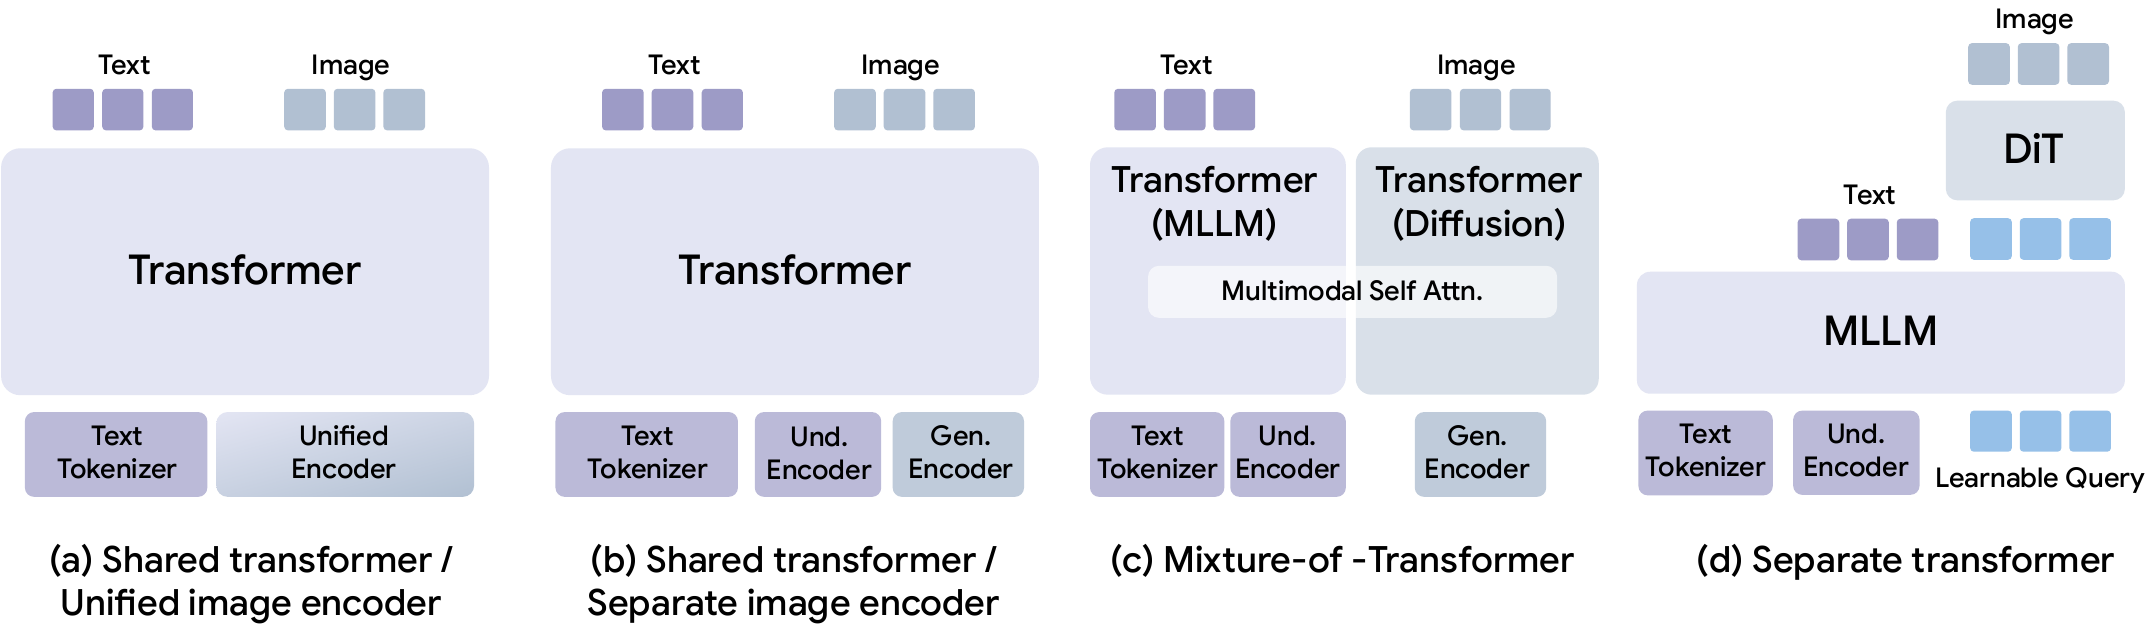
원문 Figure 1은 공유 위치를 기준으로 네 가지 구조를 비교한다. 보라색 계열의 텍스트 경로와 파란색 계열의 이미지 경로가 어느 지점에서 만나는지 보면 된다.
(a) Shared Transformer + Unified Image Encoder
Lumina-DiMOO는 understanding과 generation에서 같은 transformer와 통합 이미지 encoder/tokenizer를 사용한다. 두 task가 같은 시각 token 체계를 backbone에서 처리한다.
Understanding 학습으로 바뀐 backbone 연산을 generation에서도 사용하므로, 능력이 전달될 경로가 가장 직접적으로 공유된다. 부록에서는 같은 계열인 MMaDA도 추가 검증한다.
(b) Shared Transformer + Separate Image Encoders
Janus-Pro는 transformer를 공유하지만 시각 경로를 분리한다. Understanding에는 의미 중심 encoder를, generation에는 이미지 생성용 tokenizer를 사용한다.
따라서 understanding에서 처리한 시각 feature와 generation의 이미지 token은 입력 표현부터 다르다. Backbone을 공유하더라도 한 경로에 적응한 업데이트가 다른 경로에서도 같은 역할을 한다고 보장할 수 없다.
(c) Mixture of Transformers
BAGEL은 understanding과 generation의 transformer branch를 분리하면서 multimodal self-attention으로 정보가 교환되도록 연결한다.
전체 파라미터가 동일한 구조는 아니지만 두 branch가 완전히 독립적이지도 않다. 한쪽에서 학습한 변화가 attention을 통해 다른 쪽의 연산에 영향을 줄 가능성이 있다.
(d) Separate Transformers
BLIP3-o는 MLLM과 이미지 생성용 diffusion transformer를 분리한다. MLLM에서 얻은 conditioning signal을 별도의 생성 모듈에 전달한다.
이 구조에서는 understanding의 변화가 생성 모듈에 제공하는 조건을 통해 영향을 줄 수 있다. 반면 생성 모듈을 학습한다고 understanding backbone이 같은 방식으로 업데이트되는 것은 아니다.
공유 구조는 전달 경로에 대한 설명을 제공한다. 그러나 이 실험은 같은 모델에서 encoder만 교체한 ablation이 아니다. 서로 다른 pretrained 모델을 비교하므로 구조 외에 학습 데이터와 생성 objective 등의 차이도 함께 존재한다.
Controlled Intervention: 같은 능력, 다른 학습 방향
실험은 pretrained checkpoint에서 출발한 서로 다른 두 번의 fine-tuning으로 구성한다.
- Understanding run은 능력에 관한 이미지·질문·정답을 학습한다. Generation 목표는 추가하지 않는다.
- Generation run은 해당 능력을 표현하는 prompt와 target image를 학습한다. Understanding 목표는 추가하지 않는다.
- 각 run을 반대쪽 task에서 평가하고, 아무 추가 학습도 하지 않은 baseline과 비교한다.
두 run을 순차적으로 같은 checkpoint에 누적하는 것이 아니다. 한쪽 supervision만으로 생긴 변화가 다른 쪽의 평가에도 나타나는지를 분리해서 본다.
Counting에서는 양쪽 학습에 같은 65.6K 이미지를 사용한다. Understanding의 질문·답변과 generation의 caption은 task에 맞게 다르지만, 이미지 출처를 맞춰 “한쪽에 더 좋은 이미지가 주어졌기 때문”이라는 설명을 줄인다.
그렇다고 전체 학습 조건이 완전히 동일해지는 것은 아니다. VQA는 한 이미지에서 여러 QA pair를 얻을 수 있고, generation에는 별도의 caption을 작성한다. 데이터 형식·supervision·모델별 설정 차이는 남아 있다.
LoRA Fine-tuning과 Frozen Module
논문은 7B–8B 범위의 pretrained 모델을 사용하고, transformer block의 Q/K/V projection과 MLP layer에 rank 128 LoRA를 적용한다. 이미지 encoder, projector/aligner, language modeling head와 diffusion head 등 나머지 모듈은 freeze한다.
LoRA는 pretrained weight 전체를 업데이트하는 대신 low-rank 변화량을 학습한다. LoRA 원문의 표기로 이를 쓰면 다음과 같다. 설명에서는 별도의 scaling factor를 생략한다.
\[\begin{aligned} W &= W_0 + \Delta W \\ \Delta W &= BA \end{aligned}\]- $W_0\in\mathbb{R}^{d_{\mathrm{out}}\times d_{\mathrm{in}}}$: freeze한 pretrained weight
- $d_{\mathrm{in}},d_{\mathrm{out}}$: 해당 linear layer의 입력·출력 차원
- $A\in\mathbb{R}^{r\times d_{\mathrm{in}}}$, $B\in\mathbb{R}^{d_{\mathrm{out}}\times r}$: 추가로 학습하는 두 행렬
- $r$: 업데이트의 rank를 제한하는 값. 주요 실험에서는 128
- $\Delta W$: 두 행렬의 곱으로 표현한 weight 변화량
- $W$: 추론 시 사용하는 유효 weight
이때 모듈이 frozen이라는 것과 그 모듈을 통과하는 출력이 바뀌지 않는다는 것은 다르다. 고정된 출력 head라도 앞단 backbone의 hidden state가 바뀌면 최종 예측은 바뀐다.
이를 정보 흐름 관점에서 단순화하면, understanding loss로 학습한 LoRA가 generation에 사용되는 backbone 연산도 바꾼다. Generation head를 따로 학습하지 않았더라도 그 head에 들어가는 representation은 달라질 수 있다.
Frozen output head를 통과해도 backbone을 학습할 수 있는 이유
다음은 gradient 흐름을 설명하기 위한 일반식이며, 논문에 번호가 붙은 새로운 loss 식은 아니다.
\[\begin{aligned} h&=T_{\phi}(z),\quad o=H(h) \\ \frac{\partial\mathcal{L}}{\partial\phi} &=\frac{\partial\mathcal{L}}{\partial o} \frac{\partial H(h)}{\partial h} \frac{\partial T_{\phi}(z)}{\partial\phi} \end{aligned}\]- $z$: backbone에 입력되는 token representation
- $T_{\phi}$: 학습 가능한 LoRA 파라미터 $\phi$를 포함한 transformer
- $h$: transformer의 출력 hidden state
- $H$: weight를 freeze한 output head
- $o$: head의 출력
- $\mathcal{L}$: 현재 run에서 사용하는 task loss
$H$의 weight를 업데이트하지 않아도 입력 $h$에 대한 미분은 계산할 수 있다. 따라서 loss는 $H$를 거쳐 transformer의 LoRA 파라미터를 학습시킬 수 있다. Freeze를 출력에 대한 detach와 동일하게 생각하면 이 학습 경로를 놓치게 된다.
반대로 understanding run에 generation loss가 들어간다는 뜻은 아니다. 학습 시에는 understanding 경로의 loss를 사용하고, 학습 후 generation을 실행할 때 일부 공유 연산의 변화가 적용되는 것이다.
BLIP3-o는 task별 transformer가 분리되어 있어 각 run에서 해당 branch만 fine-tuning한다. 따라서 모든 모델에서 동일한 공유 파라미터 집합을 학습했다고 해석하면 안 된다.
Optimizer는 8-bit AdamW, 수치 정밀도는 bfloat16이며 최대 15 epoch와 early stopping으로 checkpoint를 선택한다. Lumina-DiMOO는 learning rate $3\times10^{-6}$을 사용하고, 비율을 유지한 resize와 padding으로 $512\times512$ 입력을 만든다.
모델별 learning rate와 이미지 처리 조건
부록 A의 설정이다. 모델 크기를 비슷하게 맞췄지만 learning rate와 입력 처리를 동일하게 강제하지는 않았다.
| 모델 | 부록에 기재된 규모 | Learning rate | 이미지 처리 |
|---|---|---|---|
| Lumina-DiMOO | 8B | $3\times10^{-6}$ | 긴 변 512, 짧은 변 padding |
| Janus-Pro | 7B | $4\times10^{-5}$ | 긴 변 384, 짧은 변 padding |
| BAGEL | 7B | $1\times10^{-4}$ | 기존 dynamic resizing 유지 |
| BLIP3-o | 8B | $2\times10^{-5}$ | Qwen2.5-VL backbone의 이미지 처리 유지 |
이 규모는 논문이 비교에 사용한 표기다. 이를 각 시스템의 encoder·head·모든 branch를 합친 총 파라미터 수가 정확히 같다는 뜻으로 확대하지 않는다. 나머지 설정은 각 모델의 공식 학습 설정을 따른다.
Training과 Inference의 차이
Understanding-to-generation 전략의 학습 과정에서는 이미지와 질문을 넣고 정답을 예측하도록 한다. 개수라면 숫자, 위치라면 상대 방향, OCR이라면 이미지에 있는 문자열이 supervision이다.
학습 후에는 업데이트된 모델에 일반 T2I prompt를 넣고 기존 이미지 생성 절차를 실행한다. 생성 결과를 VQA로 재검사하여 수정하거나, 외부 understanding 모델로 sampling을 guide하는 inference pipeline은 추가하지 않는다.
즉, 생성할 때 매번 “먼저 이해하고 그 답을 생성기에 전달”하는 것이 아니라, understanding 학습으로 바뀐 모델을 generation에 재사용하는 post-training 전략이다.
Experiments
Counting: Architecture별 전달 차이
먼저 counting을 probe로 사용한다. 같은 개념을 understanding에서는 “몇 개 있는가?”로, generation에서는 “몇 개를 만들 것인가?”로 평가할 수 있기 때문이다.
데이터와 평가 조건
- 학습 이미지는 PixMo-Count와 PixMo-Points에서 구성한다. Point annotation의 개수를 count로 변환하고, 20개를 넘는 어려운 예시는 제외한다. 총 65.6K 이미지와 약 200K QA pair를 사용한다.
- Generation caption은 같은 이미지와 count annotation을 바탕으로 Qwen3-VL을 통해 작성한다.
- Understanding은 PixMo-Count test split에서 만든 540 QA pair로 평가한다.
- Generation은 10개 객체 종류와 2–10의 count를 조합한 90 prompt를 사용한다. Prompt당 네 seed로 생성하여 총 360개 이미지를 평가한다.
- 생성 이미지의 count는 GenEval 방식의 object detector로 추정한다. Accuracy는 정확히 맞춘 비율, MAD는 정답에서 벗어난 평균 개수이며 작을수록 좋다.
지표의 차이를 식으로 정리하면 다음과 같다.
\[\begin{aligned} \mathrm{Acc.} &= \frac{100}{N}\sum_{i=1}^{N}\mathbf{1}[\hat c_i=c_i] \\ \mathrm{MAD} &= \frac{1}{N}\sum_{i=1}^{N}|\hat c_i-c_i| \end{aligned}\]- $N$: 평가 sample 수
- $c_i$: 정답 count
- $\hat c_i$: 예측 count. Understanding에서는 답변으로부터, generation에서는 detector로부터 얻는다.
- $\mathbf{1}[\cdot]$: 조건이 맞으면 1, 아니면 0인 indicator
- $\mathrm{Acc.}$: 백분율로 표현한 exact-match accuracy
- $\mathrm{MAD}$: count의 평균 절대 오차
예를 들어 정답이 여섯 개일 때 다섯 개와 두 개는 모두 accuracy에서 오답이다. 하지만 MAD에서는 각각 1과 4의 오차가 된다. 따라서 정확히 맞춘 횟수와 틀렸을 때 얼마나 크게 틀리는지를 함께 봐야 한다.
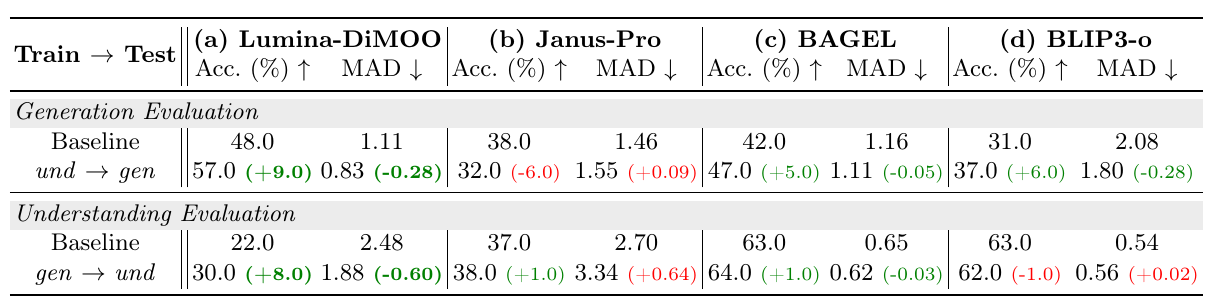
원문 Table 1의 위쪽은 $\mathrm{und}\rightarrow\mathrm{gen}$, 아래쪽은 $\mathrm{gen}\rightarrow\mathrm{und}$다. 초록색은 baseline 대비 좋은 변화, 빨간색은 나쁜 변화다.
Understanding → Generation
- Lumina-DiMOO: accuracy $48.0\%\rightarrow57.0\%$로 9.0 percentage point 상승하고, MAD는 $1.11\rightarrow0.83$으로 감소한다.
- BAGEL: accuracy $42.0\%\rightarrow47.0\%$, MAD $1.16\rightarrow1.11$로 개선된다.
- BLIP3-o: accuracy $31.0\%\rightarrow37.0\%$, MAD $2.08\rightarrow1.80$로 개선된다.
- Janus-Pro: accuracy $38.0\%\rightarrow32.0\%$, MAD $1.46\rightarrow1.55$로 악화된다.
Generation → Understanding
Lumina-DiMOO는 accuracy $22.0\%\rightarrow30.0\%$, MAD $2.48\rightarrow1.88$로 가장 뚜렷한 개선을 보인다. BAGEL도 두 지표가 소폭 개선된다.
반면 BLIP3-o는 두 지표가 악화된다. Janus-Pro는 accuracy가 $37.0\%\rightarrow38.0\%$로 조금 높아지지만 MAD가 $2.70\rightarrow3.34$로 증가한다. 이 결과를 안정적인 양방향 전달로 묶기는 어렵다.
즉, 강한 양방향 전달은 공유 backbone과 통합 시각 표현을 가진 Lumina-DiMOO에서 가장 명확하다. 그러나 분리 구조에서는 전달이 전혀 없다고 단정할 수는 없다. BLIP3-o에도 understanding에서 generation으로 향하는 개선은 존재한다.
Counting 답변을 숫자로 평가할 때의 parsing 조건
Understanding 평가 prompt는 예측 count를 **...** 안에 넣도록 예시를 제공한다. 먼저 이 marker 사이 문자열을 추출하여 정답과 비교한다.
Parsing에 실패하면 정답 숫자가 답변 어디에라도 등장하는지 확인하는 fallback을 사용한다. 아라비아 숫자와 영어 number word를 모두 허용한다.
이 fallback은 응답 형식 실패를 처리하지만, 여러 숫자가 들어간 답변까지 정답으로 잡을 여지가 있다. 따라서 이 counting score는 원문에서 정의한 parsing protocol 아래의 결과로 이해해야 한다.
Counting: 직접 Generation을 학습하는 것보다 유리한가
다음 질문은 전달이 존재한다는 관찰을 실제 학습 전략으로 사용할 수 있는가다. 이하 주요 실험은 전달이 가장 강했던 Lumina-DiMOO를 대상으로 한다.
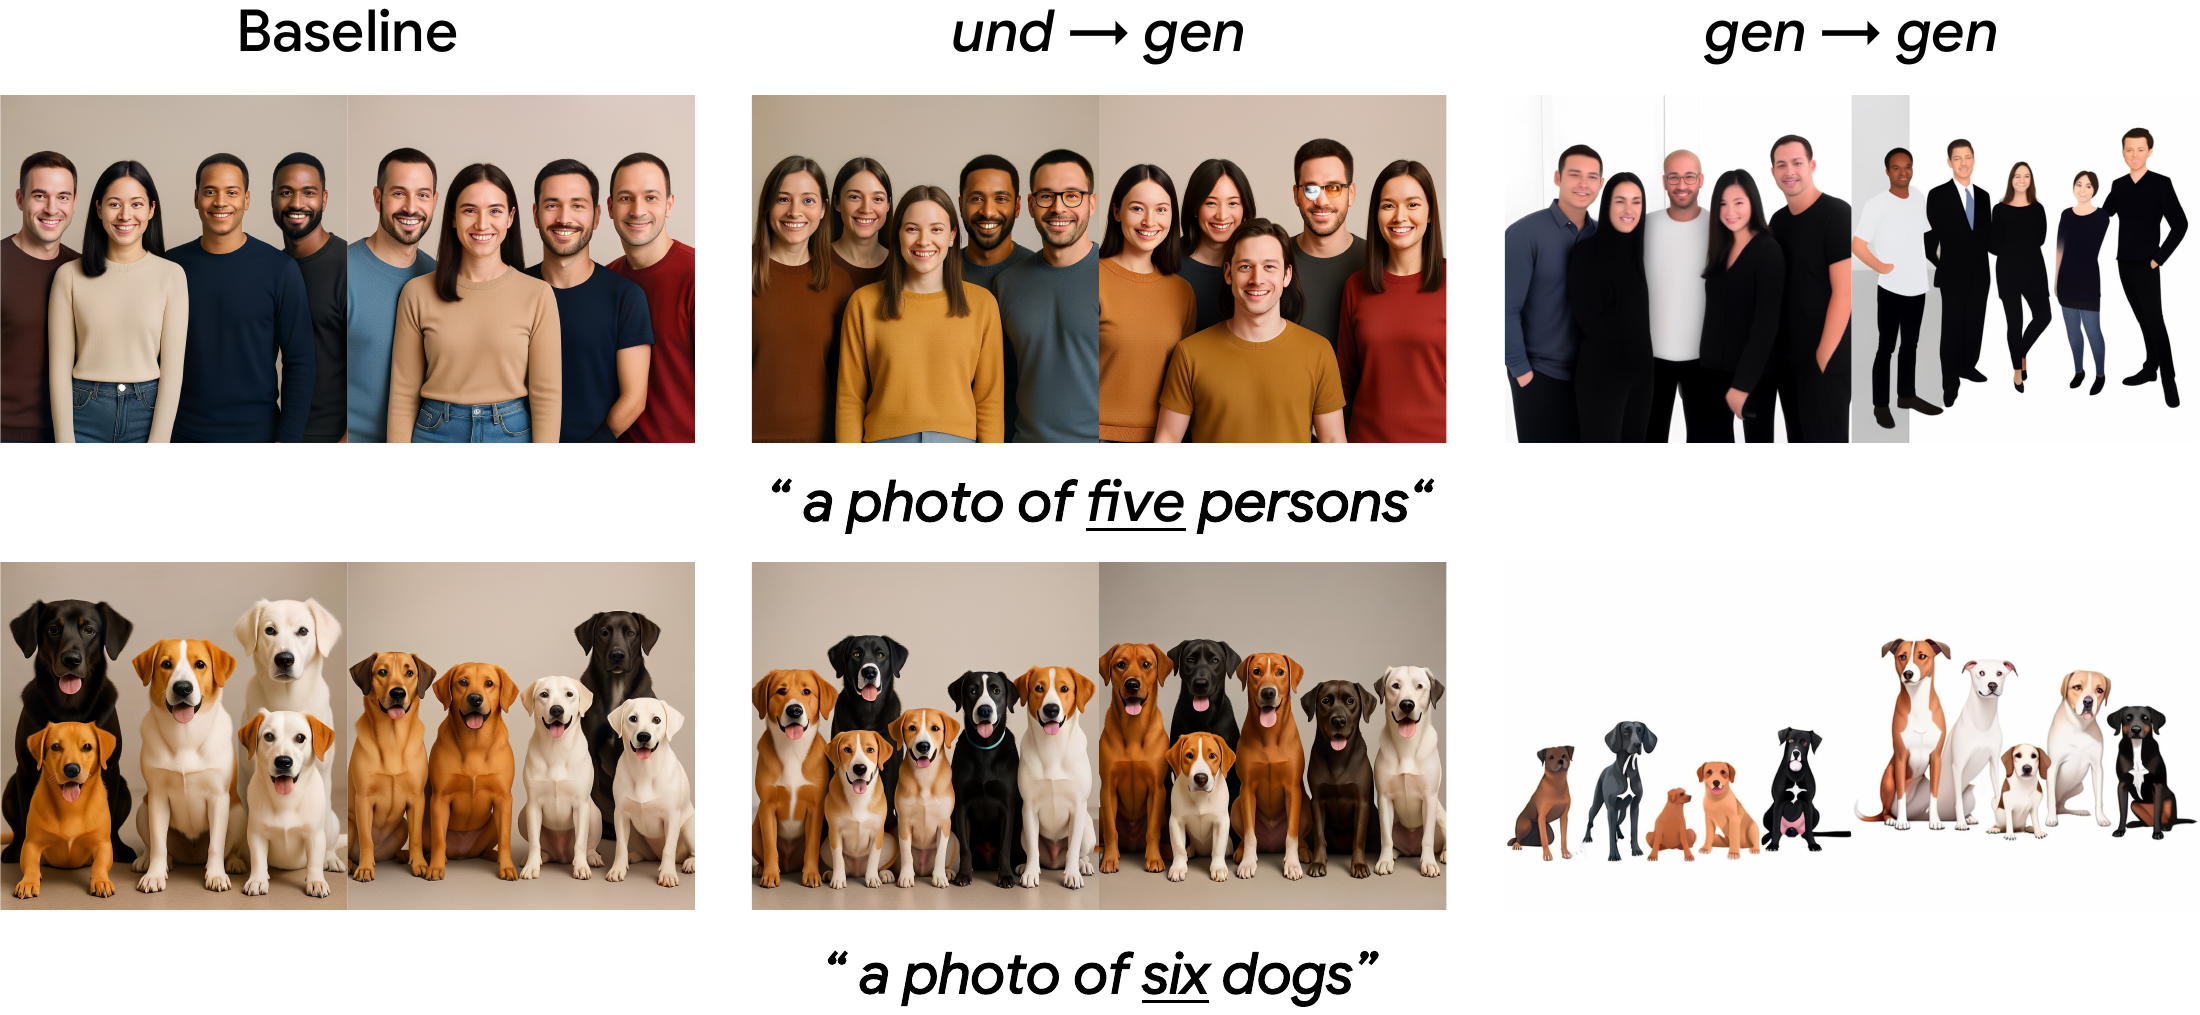
원문 Figure 3은 같은 prompt에 대한 baseline, $\mathrm{und}\rightarrow\mathrm{gen}$, $\mathrm{gen}\rightarrow\mathrm{gen}$을 왼쪽부터 비교한다. 사람과 개 예시에서 오른쪽의 직접 generation 학습은 흰 배경에 대상을 떼어 놓은 듯한 외형이 두드러진다. 가운데 전달 방식은 baseline과 비슷한 사진의 외형을 유지한다.
이 그림에서는 count만 세는 것보다 생성 분포의 외형이 어떻게 바뀌는지를 함께 보는 것이 중요하다. 개별 정성 예시의 성공 여부와 전체 평가 정확도는 구분한다.
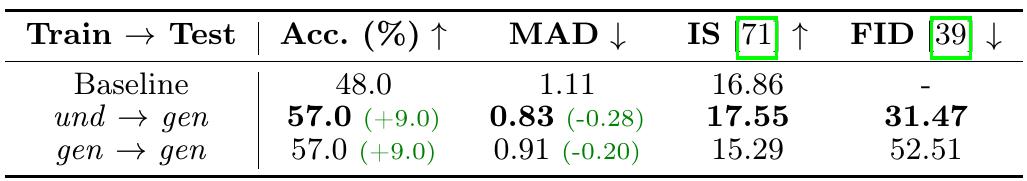
원문 Table 2에서 두 방식의 accuracy는 모두 $57.0\%$다. 하지만 MAD는 전달 방식이 0.83, 직접 학습이 0.91이다. 정확히 맞추는 비율은 같아도 틀린 sample의 평균 오차에는 차이가 있다.
이미지 분포를 비교하면 전달 방식의 FID는 31.47, 직접 학습은 52.51이다. IS도 baseline 16.86에서 각각 17.55와 15.29로 달라진다.
여기서 FID의 reference는 baseline이 생성한 이미지 집합이다. 따라서 이 결과는 전달 방식이 원래 generation 분포에서 덜 벗어났다는 근거다. 실제 사진과 더 가까워졌거나 사람의 선호도가 반드시 높아졌다는 의미로 읽으면 안 된다.
Distribution Shift: FID와 IS를 어떻게 읽어야 하는가
Counting 정확도를 올리는 것과 원래 모델의 생성 품질을 유지하는 것은 별도의 목표다. 이를 분리하기 위해 논문은 task prompt 외에도 COCO validation prompt 1K개를 사용해 생성 분포를 평가한다. 본문의 Table 2·3에서 제시한 IS/FID는 이 일반 prompt 조건의 수치와 대응한다.
부록 Table 11의 COCO 조건을 따로 보면 다음과 같다.
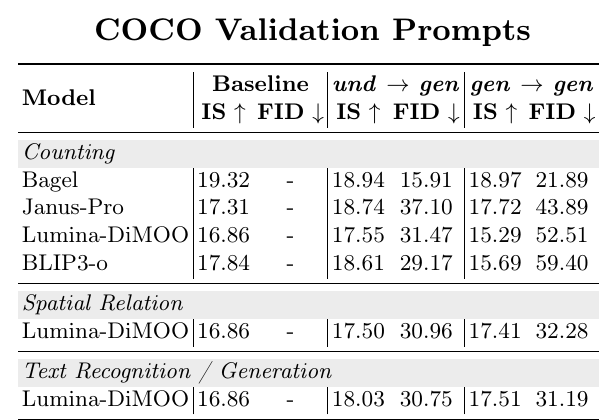
Counting으로 fine-tuning한 네 모델 모두 $\mathrm{und}\rightarrow\mathrm{gen}$의 FID가 직접 generation 학습보다 낮다. 다만 분포 변화가 작다는 사실과 목표 능력이 좋아졌다는 사실은 별개다. 앞의 Janus-Pro처럼 FID 변화는 작아도 counting 전달은 나쁠 수 있다.
Spatial relation과 text capability에서도 전달 방식이 더 낮은 FID를 보인다. 그러나 COCO 조건에서 두 방식의 차이는 counting보다 작다. Text의 FID는 전달 30.75, 직접 학습 31.19로 가까우므로 모든 task에서 아주 큰 차이가 난다고 설명해서는 안 된다.
Task prompt에서는 IS가 오히려 높아질 수 있는데 왜 품질 개선으로 단정하지 않는가
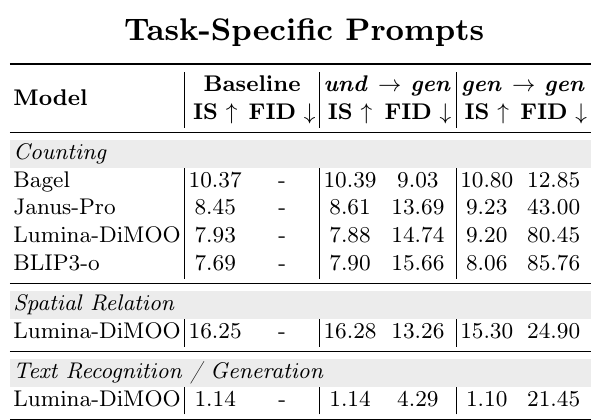
이 조건의 sample 수는 counting 1.8K, spatial relation 2K, text 1.8K다. COCO 일반 prompt 평가와 다른 이미지 집합이므로 숫자를 그대로 섞어 비교하지 않는다.
Lumina-DiMOO counting의 IS는 baseline 7.93, 전달 7.88, 직접 학습 9.20이다. 직접 학습의 IS가 가장 높다. 반면 FID는 전달 14.74, 직접 학습 80.45로 크게 차이 난다.
논문은 좁은 counting prompt 분포에 적응하면서 객체가 classifier에 더 쉽게 인식되는 외형이 될 수 있다는 설명을 제시한다. 이는 가능한 해석이며 원인이 입증된 것은 아니다.
IS는 prompt에 지정한 개수를 맞추는지를 직접 측정하지 않는다. 일반적인 사진의 자연스러움을 완전히 대표하지도 않는다. 따라서 task accuracy, baseline 기준 FID, IS, 실제 정성 결과를 함께 읽어야 한다.
Baseline의 FID가 -인 것도 같은 이유다. 표는 baseline을 reference로 한 변화량을 보고하며, baseline의 실제 사진 대비 FID를 별도로 제공하지 않는다.
Spatial Relation: 합성 데이터의 배치 정보만 전달할 수 있는가
이번에는 개수가 아니라 두 객체 사이의 상대 배치를 학습한다. 기존 모델이 단순한 left/right/top/bottom은 비교적 잘 처리하기 때문에, 논문은 대각선 방향 네 가지에 집중한다.
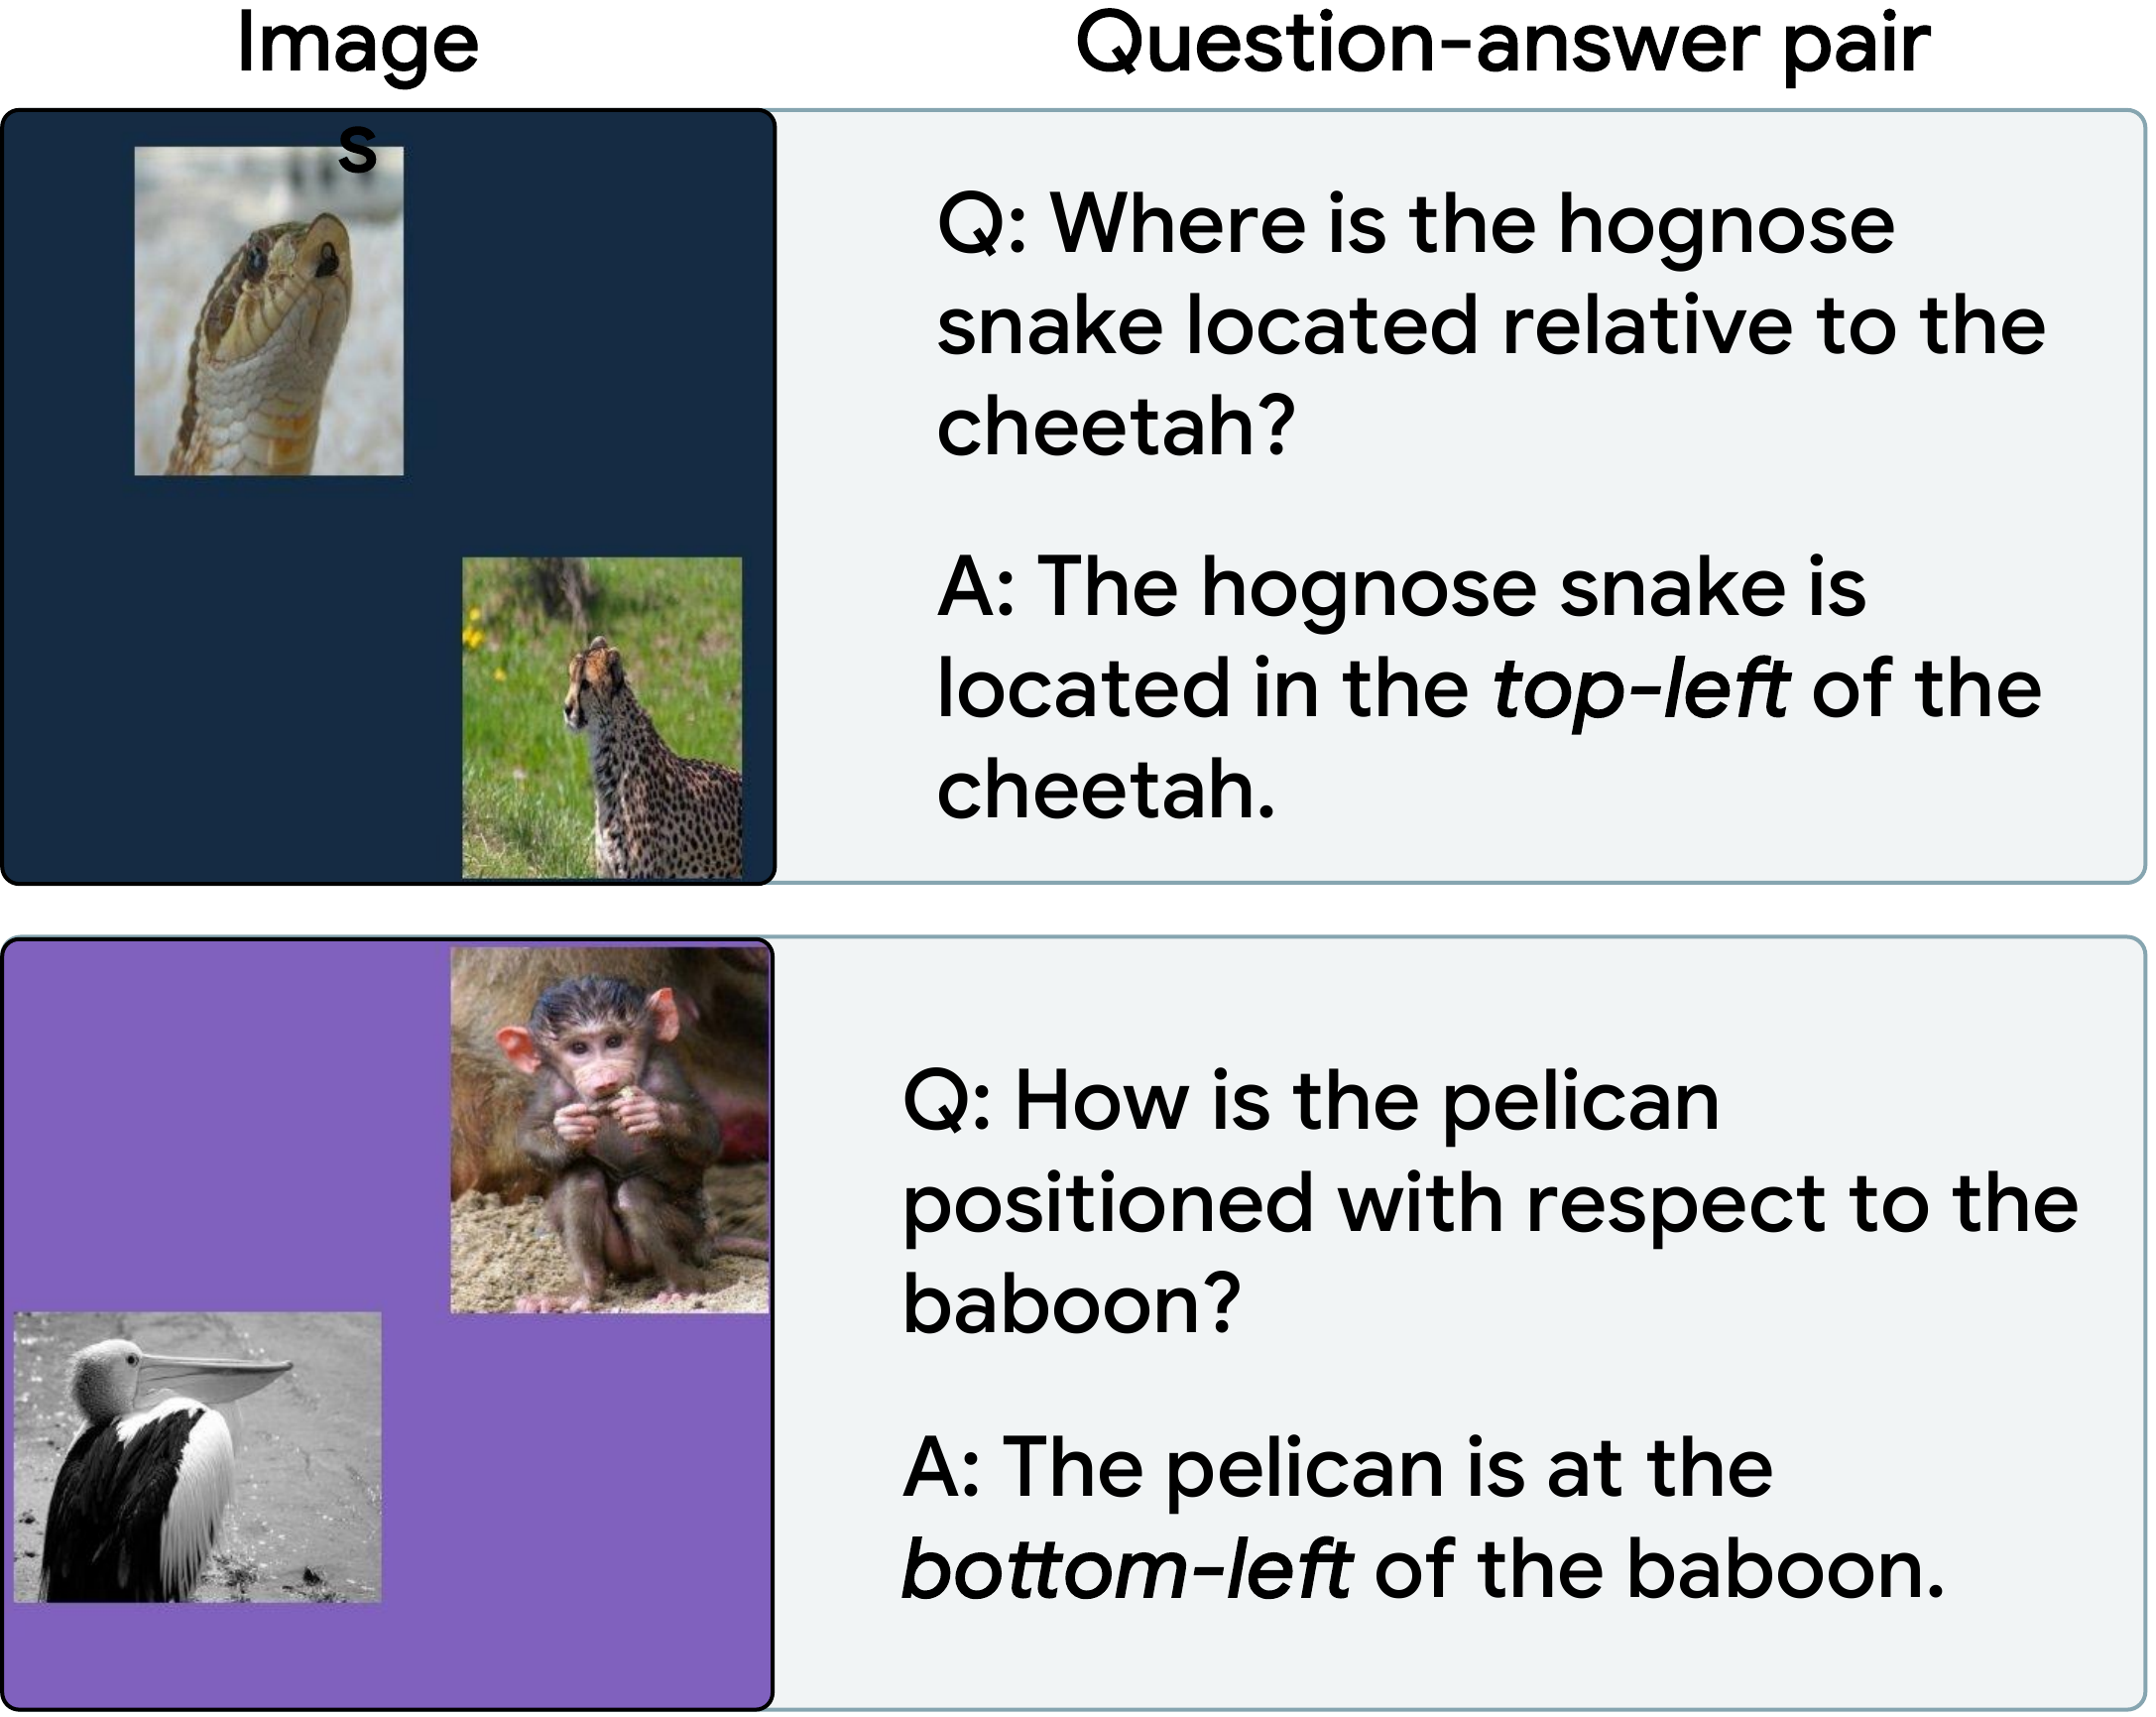
원문 Figure 4의 위쪽에서는 뱀이 치타의 top-left에, 아래쪽에서는 펠리컨이 개코원숭이의 bottom-left에 놓여 있다. 그림과 QA pair의 방향이 어떻게 연결되는지 확인할 수 있다.
데이터 구성
ImageNet-1K의 서로 다른 class에서 두 이미지를 뽑아 $512\times512$ canvas에 붙인다. 배경색과 crop 크기를 바꾸고, 두 이미지가 겹치지 않으며 방향이 명확하도록 배치한다.
Top-left, top-right, bottom-left, bottom-right를 각각 50K개씩 만들어 총 200K sample을 구성한다. Understanding에는 객체 A가 B의 어느 방향에 있는지 묻는 QA를, generation에는 같은 이미지와 관계 annotation에 기반한 prompt를 사용한다.
여기서 synthetic image는 객체의 상대 배치를 명확히 가르치지만 자연스러운 scene은 아니다. 때문에 이 실험은 관계 정보와 데이터 외형을 얼마나 함께 학습하는가를 보기 좋은 조건이다.
평가 조건
Understanding 평가는 250 validation sample을 네 방향 중 하나를 고르는 multiple-choice 질문으로 변환한다. Generation 평가는 100 prompt와 prompt당 네 seed를 사용한다. Detector로 두 객체의 bounding box를 찾고, 중심점의 상대 위치로 방향을 결정한다.
이미지 좌표에서 아래로 갈수록 $y$가 커지므로 top-left 조건은 다음과 같다.
\[\begin{aligned} \Delta x&=x_A-x_B<0 \\ \Delta y&=y_A-y_B<0 \end{aligned}\]- $(x_A,y_A)$: 객체 A의 detected bounding box 중심
- $(x_B,y_B)$: 기준 객체 B의 detected bounding box 중심
- $\Delta x,\Delta y$: B를 기준으로 한 A의 상대 위치
두 부호가 각각 $(+,-)$이면 top-right, $(-,+)$이면 bottom-left, $(+,+)$이면 bottom-right다.
부록의 protocol에서는 어느 한 객체라도 검출하지 못하면 sample을 평가에서 제외한다. 따라서 이 accuracy는 검출된 객체 사이의 관계 정확도이며, 모든 prompt에서 두 객체가 성공적으로 생성되었는지를 포함한 종합 성공률과는 다르다.
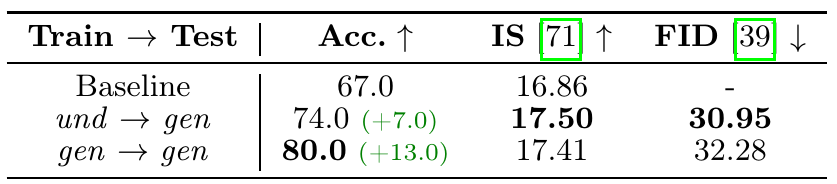
원문 Table 3에서 accuracy는 baseline 67.0%, 전달 방식 74.0%, 직접 학습 80.0%다. 전달은 7.0 percentage point 개선되지만, 위치 정확도만 보면 직접 generation 학습이 더 좋다.
FID는 각각 전달 30.95, 직접 학습 32.28이다. 이 차이를 이미지 외형과 함께 읽으면 학습 전략의 trade-off를 이해할 수 있다.
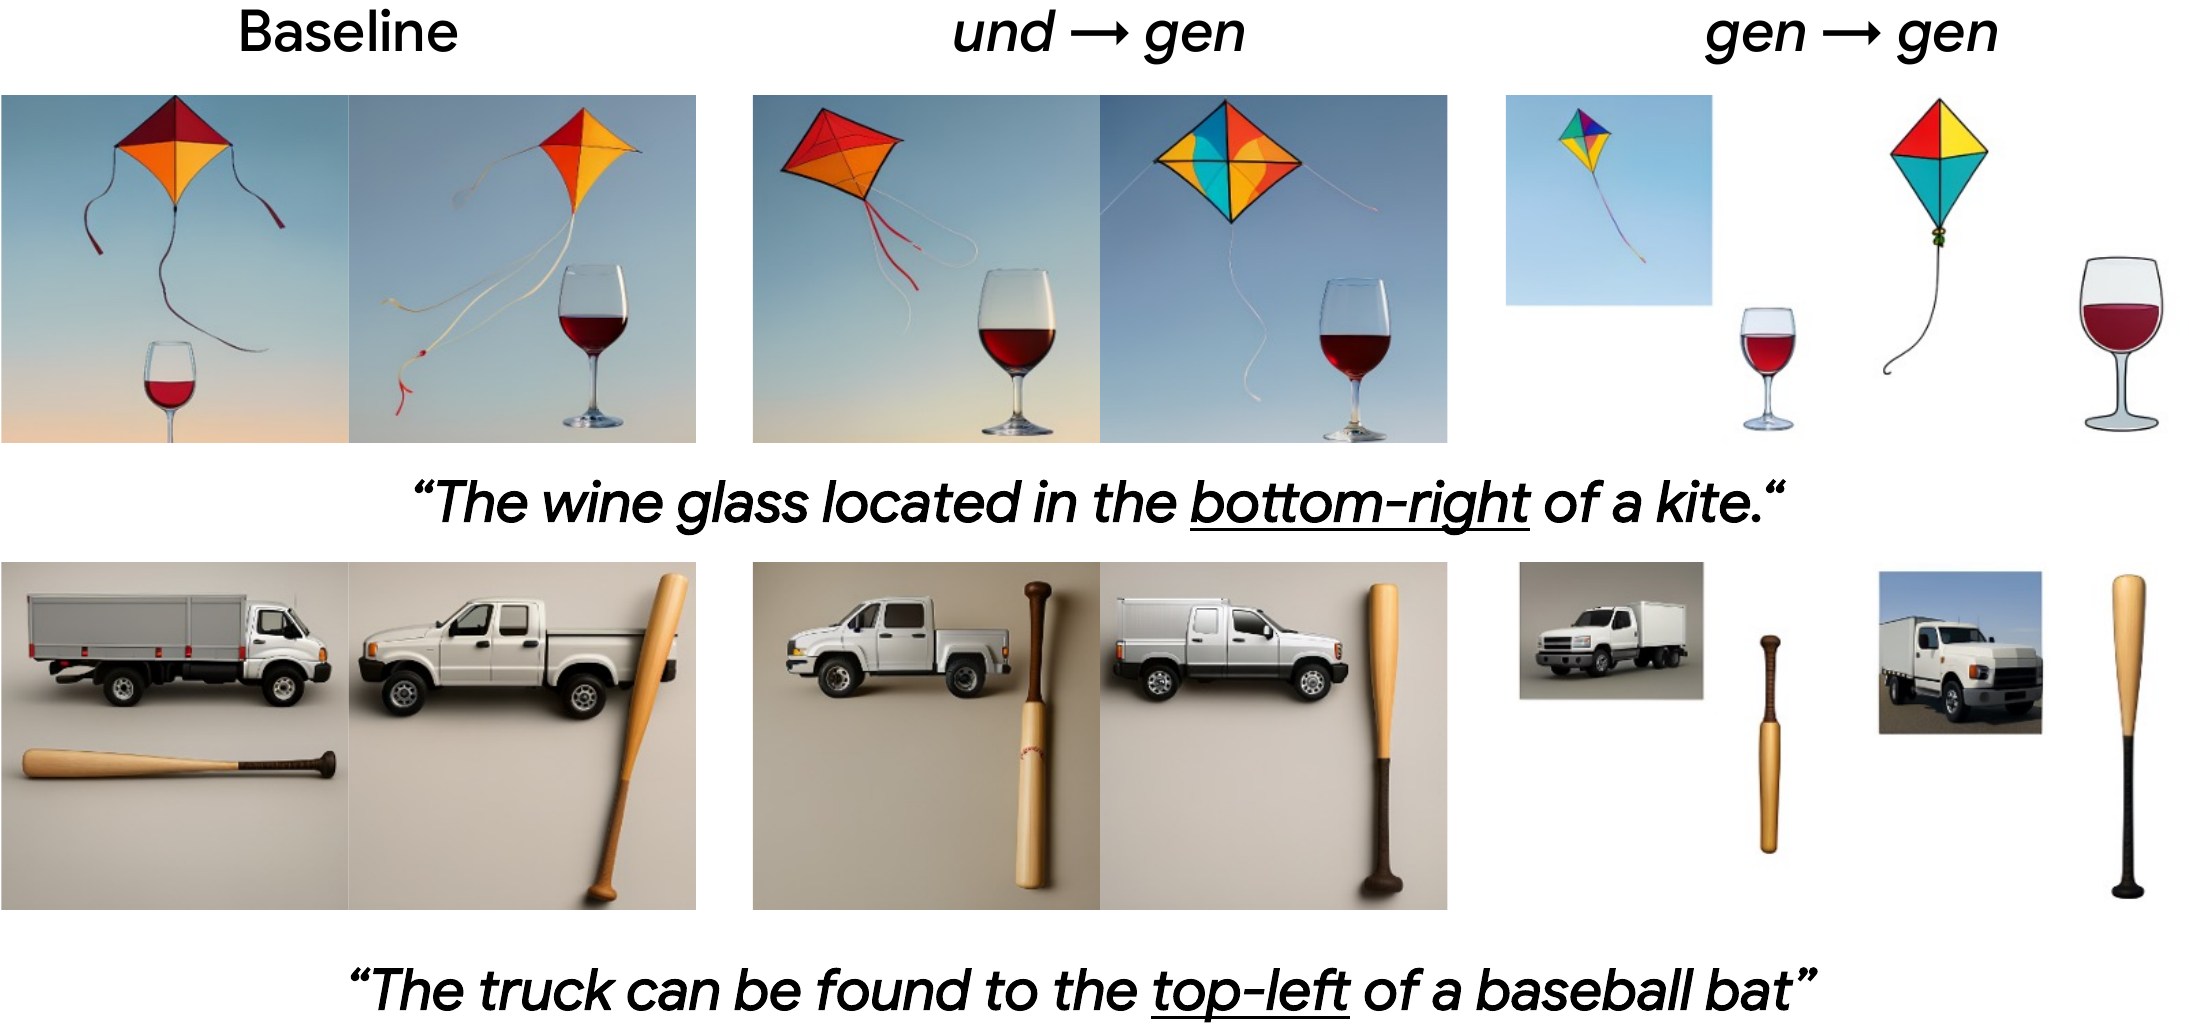
원문 Figure 5의 첫 행은 wine glass와 kite, 둘째 행은 truck과 baseball bat의 배치다. 오른쪽의 직접 학습 결과는 흰 배경 위에 객체 사진을 붙인 형태로 바뀐다. 가운데의 전달 결과는 관계를 보강하면서 baseline의 scene 외형을 비교적 유지한다.
즉, 이 실험의 결론은 “전달이 항상 정확도가 가장 높다”가 아니다. 직접 학습의 더 높은 관계 정확도와, 전달 방식의 더 작은 분포 변화 사이에 선택지가 생긴다는 것이다.
Text Recognition / Generation: 세밀한 시각 정보도 전달되는가
Counting과 spatial relation은 개수와 배치 같은 구조적 개념을 다룬다. 문자 생성은 획, 문자 사이 간격, glyph 형태처럼 훨씬 세밀한 시각 정보를 요구한다.
논문은 discrete tokenizer에서 너무 작은 scene text나 조밀한 문서가 어려울 수 있다는 점을 고려해, 적당한 난도의 합성 OCR 데이터를 만든다.
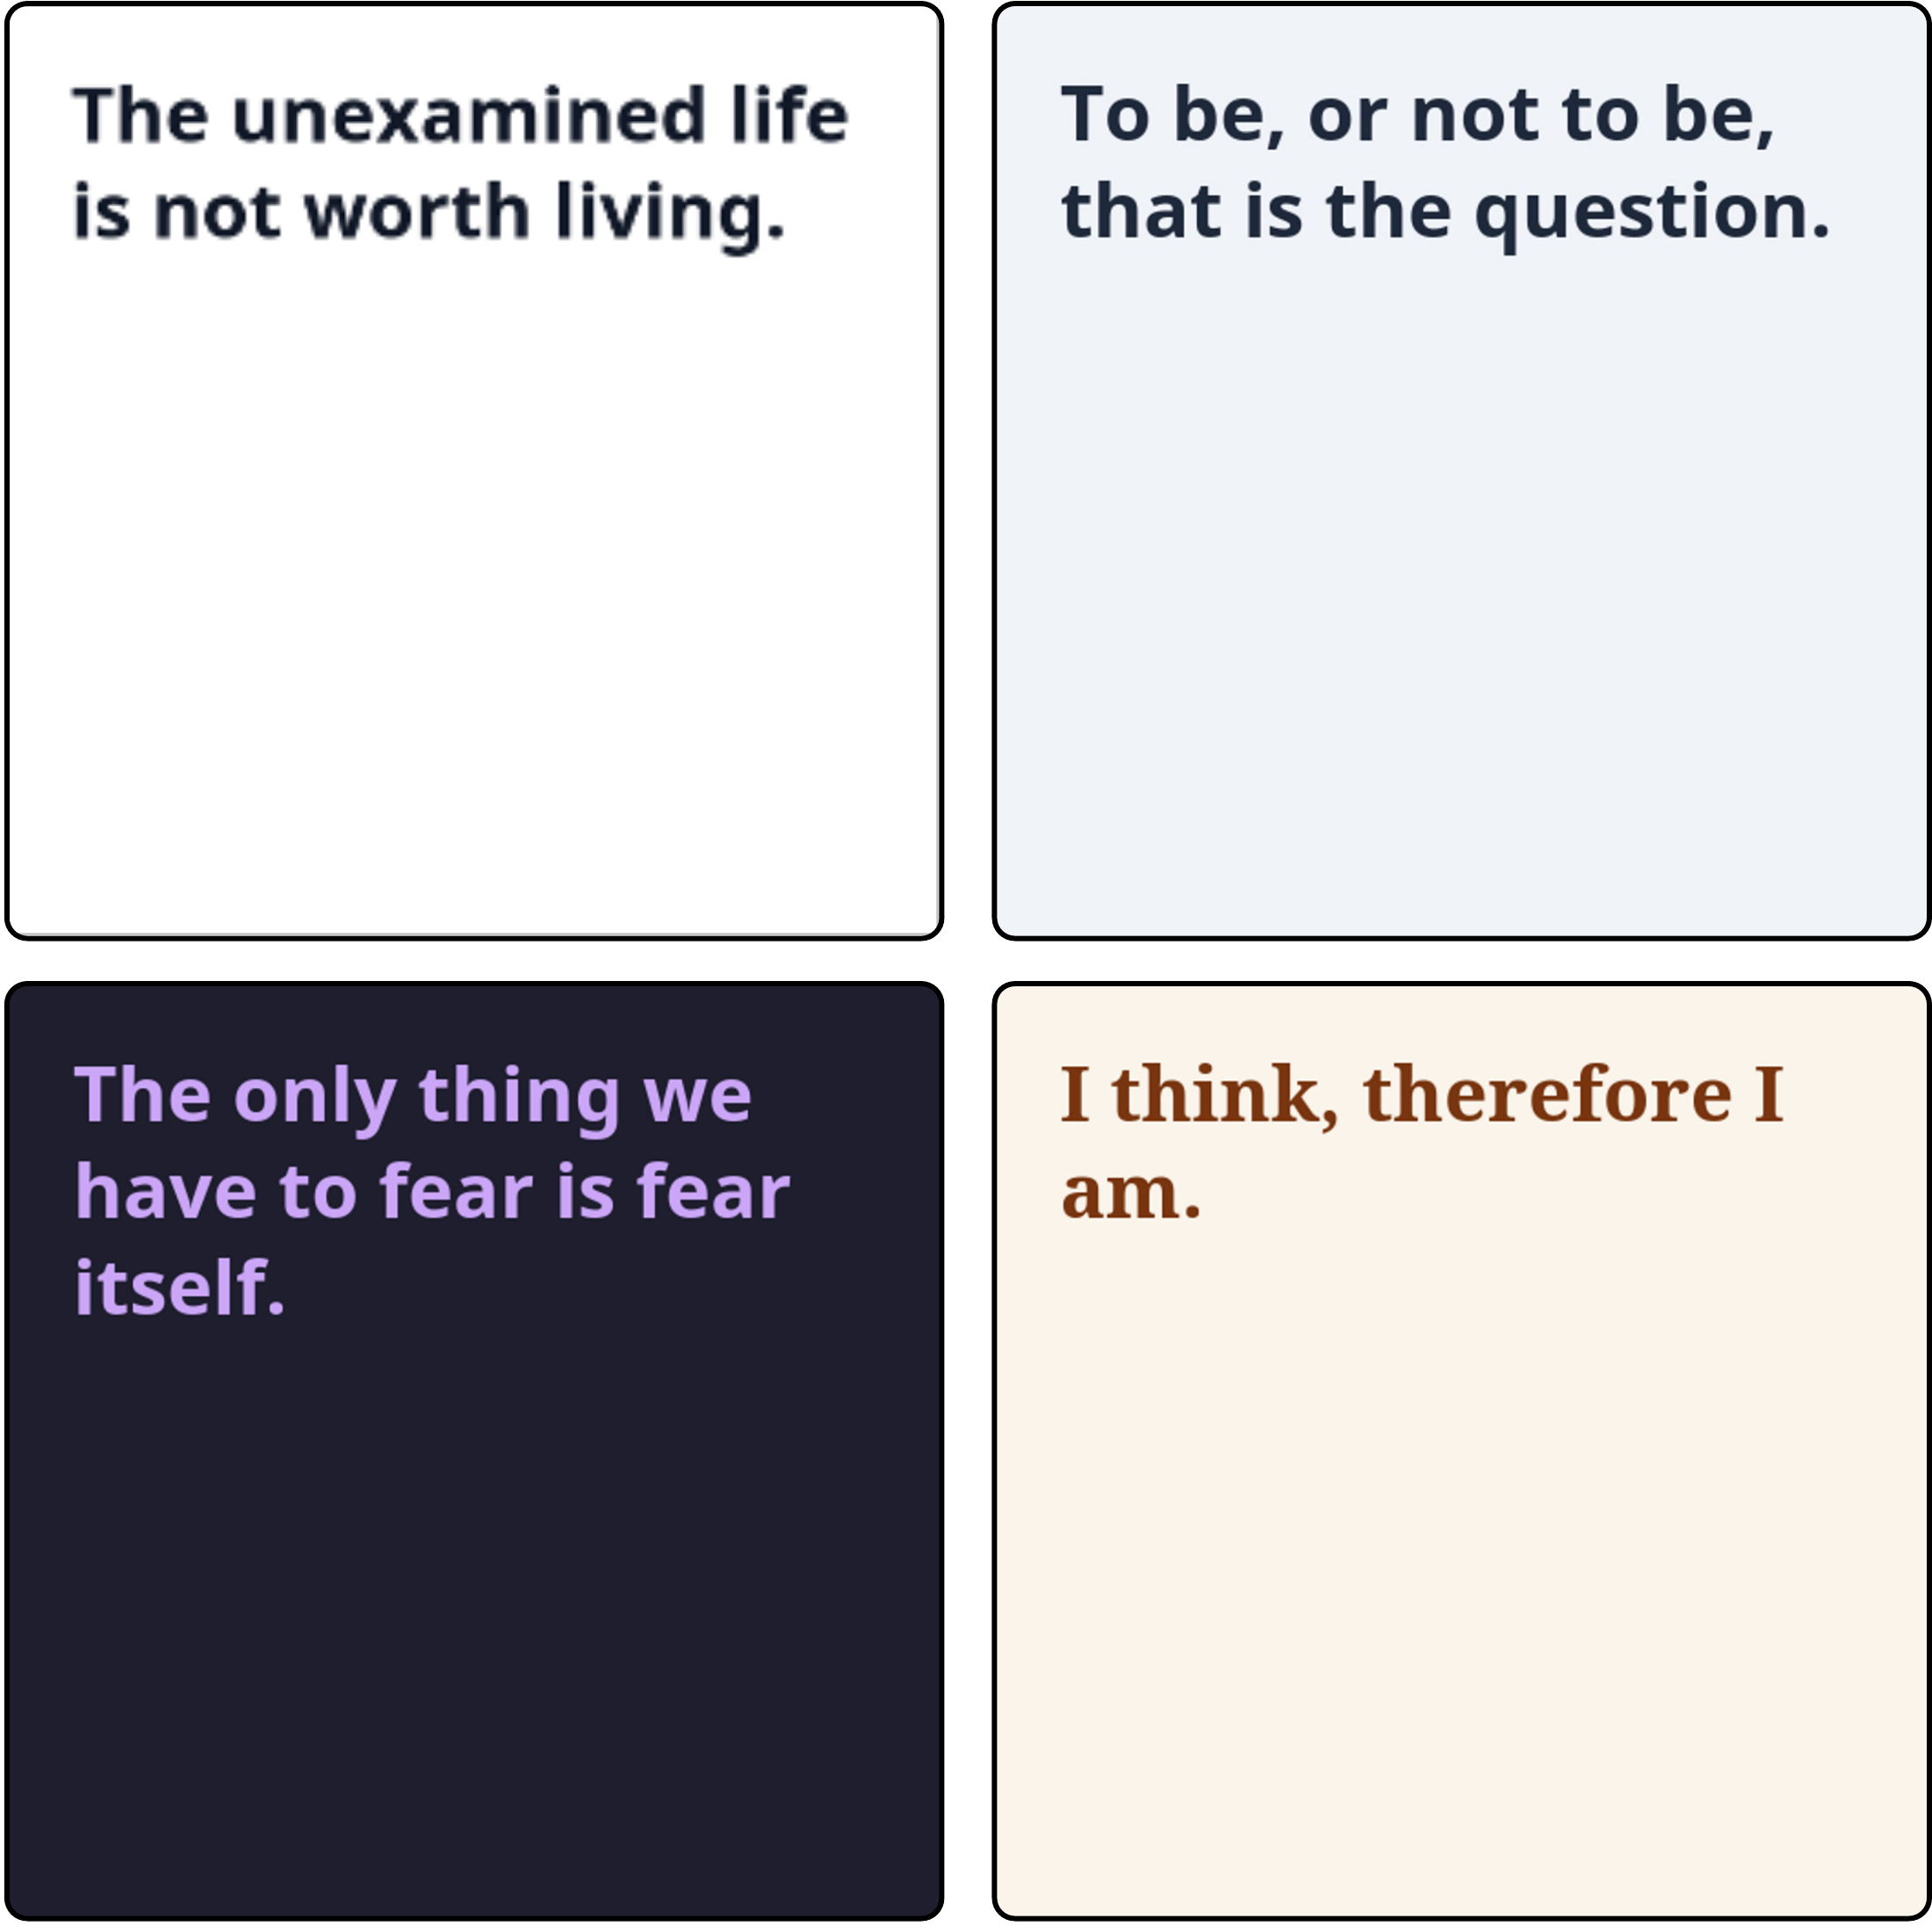
원문 Figure 6처럼 배경색과 글꼴이 다른 텍스트 이미지를 만든다. 부록 B.3에 따르면 실제 구성은 긴 자유 형식 문서 전체가 아니라 최대 120자의 영어 문장을 하나의 Markdown H1으로 렌더링하는 방식이다.
공개 영어 문장 corpus의 training split에서 첫 200K sample을 사용한다. Understanding은 네 가지 CSS template 중 하나를 무작위로 선택하지만, generation은 clean_light template만 사용한다.
즉, 양쪽에 같은 문장 내용을 사용하더라도 template 다양성까지 완전히 동일한 학습 조건은 아니다.
- Understanding 입력: 렌더링된 이미지와
Extract all text from the image.라는 지시 - Understanding 정답: 원래 영어 문장
- Generation 입력: 문장을 포함한 Mathpix 스타일의 렌더링 prompt
- Generation 정답: 해당 문장을 렌더링한 이미지
평가
Test split 첫 250개 문장을 사용한다. Generation 결과에는 GLM-OCR을 적용해 텍스트를 읽고, reference와 prediction을 소문자로 변환하고 공백·줄바꿈을 정규화한 뒤 비교한다.
WER와 CER는 각각 단어·문자 단위 오류율, edit distance는 문자열을 맞추는 데 필요한 편집 횟수다. BLEU와 METEOR는 문자열의 일치 정도를, token-level F1은 precision과 recall의 균형을 측정한다. F1 자체가 문자 획이나 모든 token 순서를 직접 평가하는 것은 아니다.
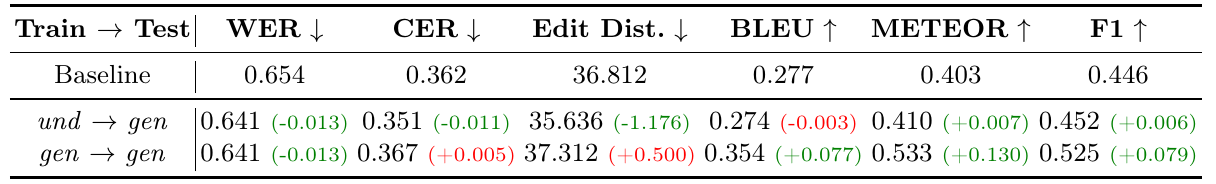
원문 Table 4에서 $\mathrm{und}\rightarrow\mathrm{gen}$은 WER 0.654 → 0.641, CER 0.362 → 0.351, edit distance 36.812 → 35.636으로 개선된다. METEOR와 F1도 조금 높아진다. 반면 BLEU는 0.277 → 0.274로 소폭 낮아진다.
따라서 문자에서도 전달은 존재하지만, 대부분 지표의 개선 폭이 작고 모든 지표가 좋아지는 것은 아니다.
직접 generation 학습은 BLEU·METEOR·F1에서 더 큰 개선을 보인다. 그러나 WER는 전달과 같은 0.641이며, CER는 0.367, edit distance는 37.312로 오히려 baseline보다 나쁘다. “직접 학습이 문자 정확도의 모든 지표에서 더 좋다”는 해석은 표와 맞지 않는다.
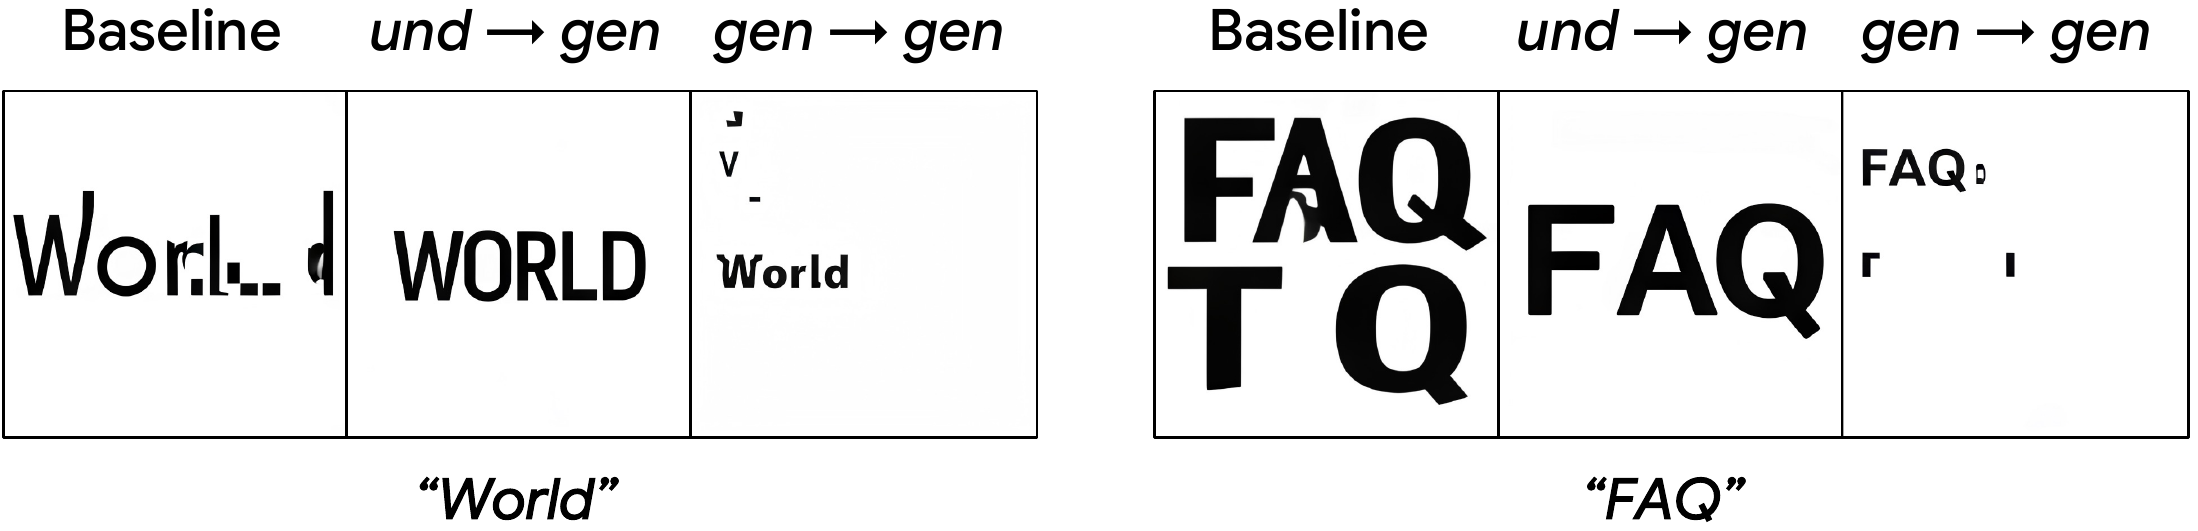
원문 Figure 7은 짧은 World, FAQ 예시다. 가운데 전달 결과에서는 문자 덩어리가 비교적 정돈되고, 오른쪽 직접 학습에서는 작은 문자나 불필요한 조각이 보인다.
다만 이 짧은 예시를 250개 영어 문장의 정량 결과와 동일한 난도로 보면 안 된다. 또한 평가 score에는 생성 이미지의 품질뿐 아니라 GLM-OCR의 인식 오류도 포함될 수 있다.
Transfer Strength: 어느 방향이 더 강한가
전달이 존재하는지만으로는 효과의 크기를 비교하기 어렵다. 논문은 같은 target task를 직접 학습했을 때의 개선량을 reference로 삼아 transfer strength를 계산한다.
Score가 클수록 좋은 지표에 대한 정의를 풀어 쓰면 다음과 같다.
\[S_{a\rightarrow b} =\frac{m_b(\theta_a)-m_b(\theta_0)} {m_b(\theta_b)-m_b(\theta_0)}\times100\%\]- $a$: source task, 추가 학습을 수행한 쪽
- $b$: target task, 전달을 평가하는 쪽
- $\theta_0$: baseline checkpoint
- $\theta_a$: source task만 학습한 checkpoint
- $\theta_b$: target task를 직접 학습한 checkpoint
- $m_b$: target task의 평가 score
- $S_{a\rightarrow b}$: 직접 학습 개선량에 대한 전달 개선량의 비율
MAD·WER처럼 작을수록 좋은 지표는 개선량을 baseline 값 − 학습 후 값으로 계산한다. 분모가 0에 가까우면 비율이 불안정할 수 있으므로 절대 개선량도 함께 확인해야 한다.
Counting generation accuracy에서는 baseline 48%, 전달 57%, 직접 학습 57%이므로 $9/9=100\%$다. MAD에서는 전달이 0.28, 직접 학습이 0.20만큼 좋아져 $0.28/0.20=140\%$가 된다.
논문은 직접 학습을 전달의 upper bound로 가정한다고 표현하지만, 실제 결과가 100%를 넘으므로 수학적으로 보장된 상한은 아니다. 여기서는 비교를 위한 기준값으로 이해하는 편이 정확하다.
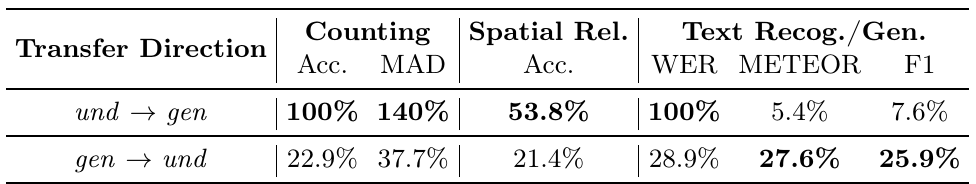
원문 Table 6에서 counting과 spatial relation은 understanding → generation이 더 강하다. Spatial accuracy의 비율은 전달 방향이 53.8%, 역방향이 21.4%다.
Text에서는 METEOR·F1 기준으로 generation → understanding이 더 강하다. 하지만 WER는 understanding → generation 100%, 역방향 28.9%로 반대다. 따라서 “문자는 무조건 역방향이 더 강하다”는 한 문장으로 압축하기 어렵다.
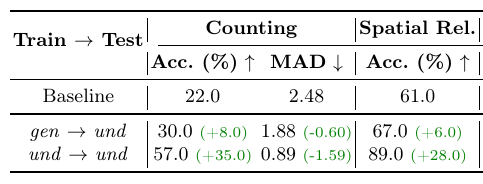
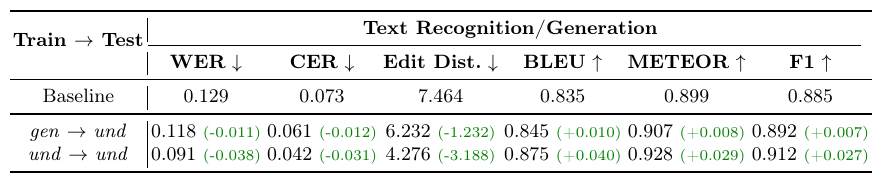
가독성을 위해 원문 Table 5를 counting·spatial relation과 OCR 부분으로 나누었다. 아래 표의 행 제목은 같은 원문에서 반복하여 붙였으며 숫자는 변경하지 않았다.
원문 Table 5에서는 generation만 학습한 모델의 OCR understanding이 WER 0.129 → 0.118, CER 0.073 → 0.061로 개선된다. 직접 understanding 학습은 각각 0.091, 0.042로 더 좋다. 전달은 존재하지만 직접 학습을 완전히 대체하는 수준은 아니다.
논문의 해석은 필요한 시각 정보의 세밀함이 전달 방향에 영향을 줄 수 있다는 것이다. 개수·관계는 구조적 representation을 통해 전달되기 쉽고, 문자 렌더링에 필요한 획의 정밀도는 generation supervision에서 더 직접적으로 학습될 수 있다.
다만 이는 관찰을 설명하기 위한 가설이다. 각 지표의 예외도 있고, 시각 정보의 granularity만을 조작한 실험으로 원인을 확정한 것은 아니다.
Joint Training: 전달이 있으면 두 Task를 함께 학습해도 좋은가
한쪽 학습의 변화가 다른 쪽에도 도움이 된다면 두 objective를 함께 학습하는 편이 더 좋을 것처럼 보인다. 논문은 counting understanding과 generation을 동시에 학습하여 이를 확인한다.
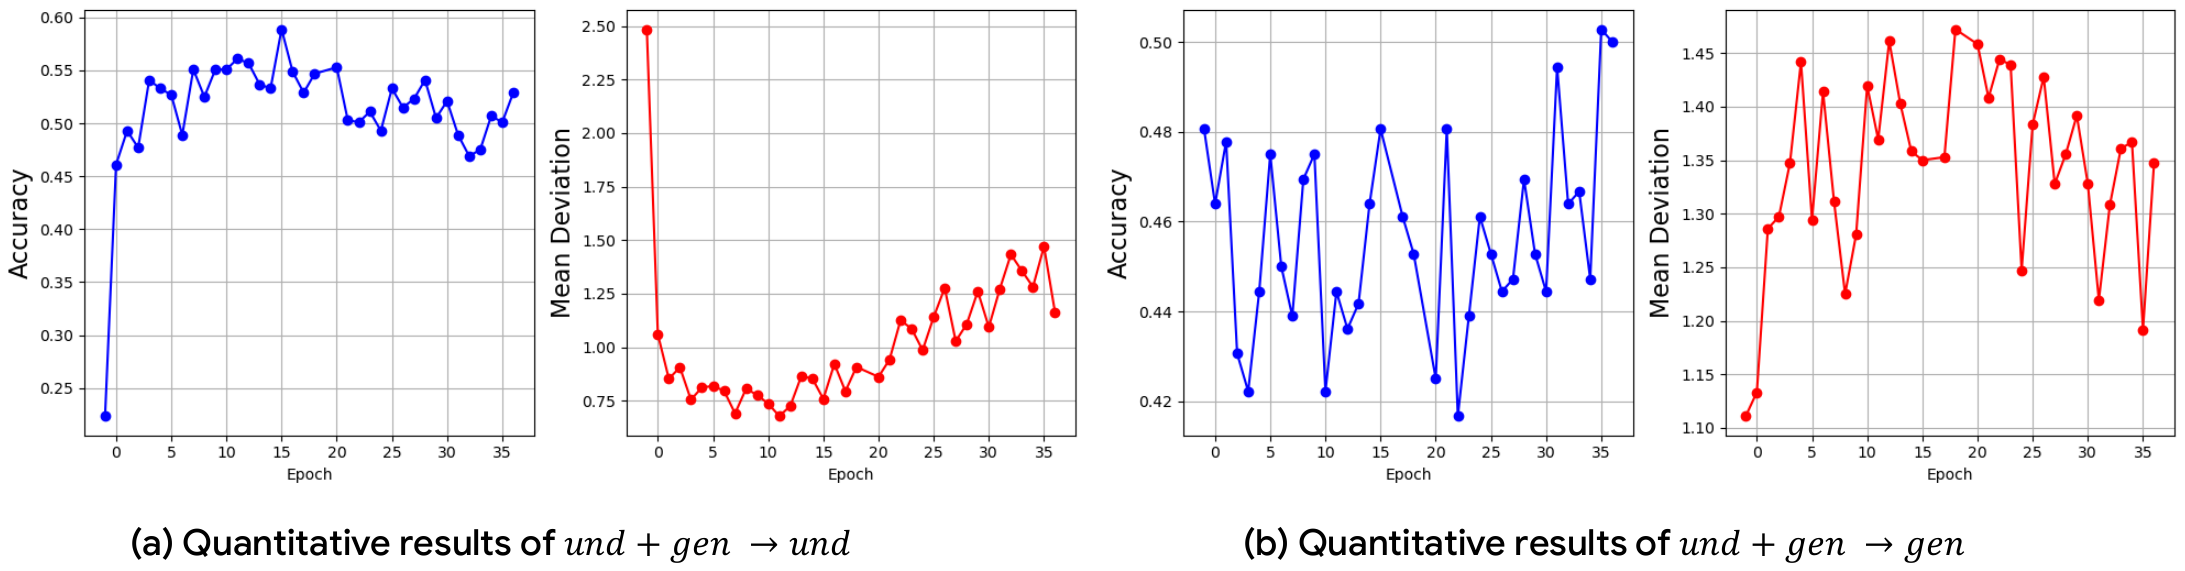
원문 Figure 8의 왼쪽 (a)는 understanding, 오른쪽 (b)는 generation이다. 각 패널에서 파란 선은 accuracy, 빨간 선은 MAD이며, 가로축은 epoch다.
두 task의 성능은 함께 매끄럽게 좋아지지 않는다. 초반 understanding이 좋아지는 구간에서 generation은 나빠지고, 후반에는 반대 방향의 변화가 나타난다.
한쪽 objective로 얻은 업데이트가 다른 task에 도움이 되는 것과, 두 objective를 동시에 최적화할 때 서로 잘 맞는 것은 다른 문제다.
논문은 두 task가 요구하는 alignment pattern의 차이로 학습 신호가 충돌할 가능성을 제시한다. 동시에 pretrained 모델에 대한 post-training이라는 점과 counting에 집중된 paired data의 특수성도 가능한 이유로 남긴다.
이 실험만으로 대규모 pre-training에서도 joint training이 항상 나쁘다거나, gradient 충돌이 유일한 원인이라고 단정할 수는 없다.
General Multimodal Ability는 유지되는가
특정 능력에 집중한 understanding 학습이 다른 이해 능력을 손상시키지 않는지도 확인한다.
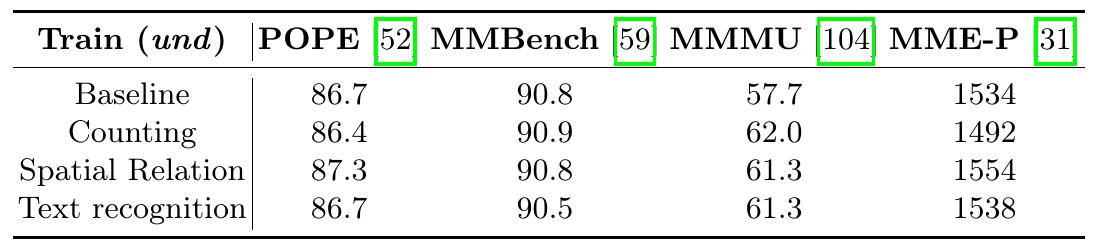
원문 Table 7에서 POPE와 MMBench는 baseline과 대체로 비슷하고, MMMU는 57.7에서 61.3–62.0으로 높아진다. 전반적인 이해 능력을 크게 잃지 않았다는 근거다.
그렇지만 모든 score가 유지되거나 좋아지는 것은 아니다. Counting 학습 후 POPE는 86.7 → 86.4, MME-P는 1534 → 1492로 낮아진다. OCR 학습 후 MMBench도 90.8 → 90.5로 낮아진다.
따라서 결과는 “일반 능력이 전반적으로 보존된다”는 수준으로 읽는다. 네 benchmark에서 작은 하락이 전혀 없거나, 모든 일반 능력의 보존을 보장한다는 뜻은 아니다.
Additional Analysis: 공유 Representation과 학습 강도
MMaDA에서도 전달되는가
Architecture별 한 모델만 비교하면 Lumina-DiMOO에만 특수한 결과일 가능성이 남는다. 부록 C.1은 같은 공유 구조와 generation objective를 사용하는 MMaDA를 추가한다.
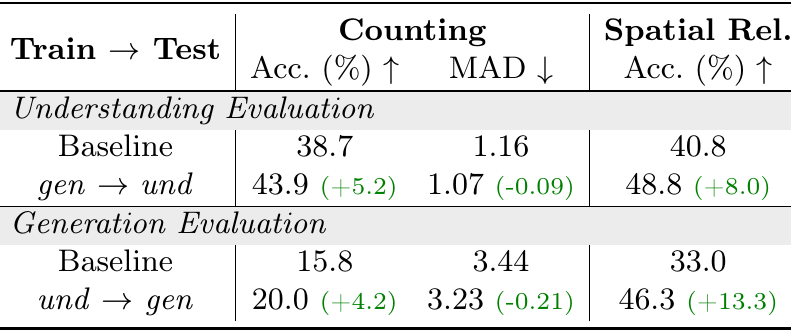
원문 Table 10에서 understanding → generation은 counting accuracy 15.8% → 20.0%, spatial accuracy 33.0% → 46.3%로 개선된다. 반대 방향도 counting 38.7% → 43.9%, spatial 40.8% → 48.8%로 개선된다.
서로 다르게 pretrained된 같은 계열의 모델에서도 전달을 관찰했다는 추가 근거다. 그러나 모델 계열별 폭넓은 재현이나 구조의 인과적 증명으로 확대하기에는 비교 범위가 제한적이다.
Generation Attention도 바뀌는가
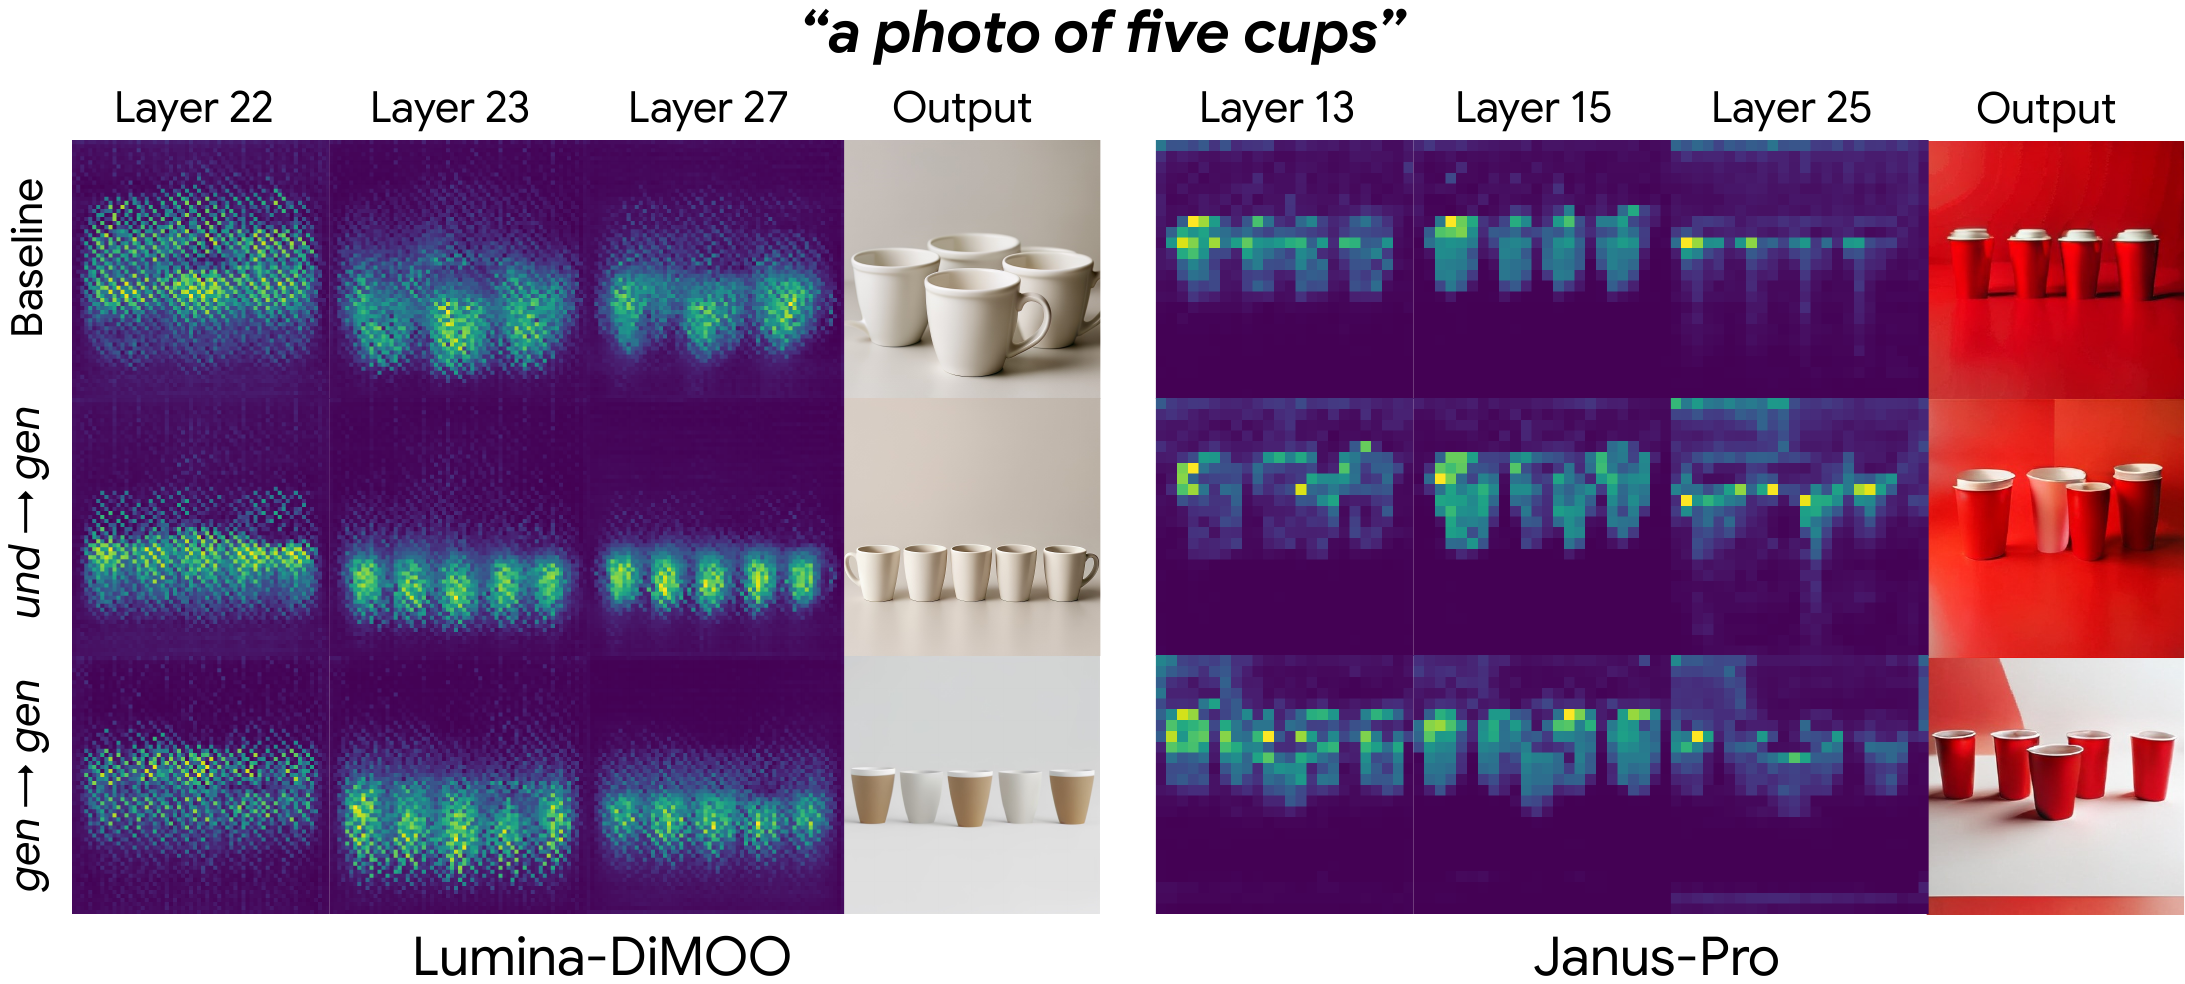
부록 Figure 10은 a photo of five cups prompt의 cups token을 query로, 생성 이미지 token을 key로 하는 attention을 시각화한다. Head별 score를 평균하고 이미지 token의 공간 배치로 펼친 것이다.
왼쪽 Lumina-DiMOO에서 가운데 $\mathrm{und}\rightarrow\mathrm{gen}$ 행은 baseline보다 컵 영역에 집중된 패턴을 보인다. 오른쪽 Janus-Pro는 세 학습 조건 사이의 변화가 상대적으로 작다.
이 관찰은 출력 score뿐 아니라 텍스트 개념이 생성 이미지 token에 연결되는 방식도 바뀔 수 있다는 해석을 보조한다. 다만 attention이 전달의 원인을 직접 증명하는 것은 아니다.
특히 Lumina-DiMOO는 총 64 denoising step 중 2 step 이후의 초기 attention을, Janus-Pro는 autoregressive 생성 완료 후의 attention을 사용한다. Layer와 생성 시점이 다르므로 두 heatmap의 밝기나 선명함을 완전히 같은 조건의 정량 비교로 읽으면 안 된다.
LoRA Rank를 높이면 전달이 강해지는가
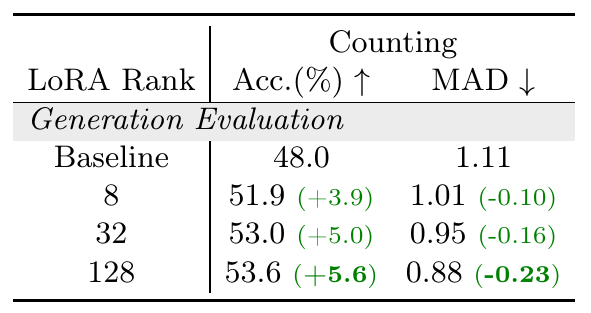
부록 Table 12는 Lumina-DiMOO의 counting understanding → generation을 동일한 3K training step에서 비교한다.
Baseline 48.0%에 대해 rank 8, 32, 128의 accuracy는 각각 51.9%, 53.0%, 53.6%다. MAD도 1.01, 0.95, 0.88로 순차적으로 개선된다. 이 조건에서는 더 큰 adaptation capacity가 더 강한 전달과 연결된다.
이 표의 rank 128 결과 53.6%와 주요 실험의 57.0%는 평가할 checkpoint를 선택하는 학습 조건이 다르다. Rank 비교를 위해 step을 고정한 ablation과 주요 run의 best checkpoint 수치를 섞으면 안 된다.
또한 부록에서는 counting 데이터만으로 full fine-tuning했을 때 학습이 불안정하고 generation 품질이 붕괴한 결과를 보고한다. 따라서 더 많은 파라미터를 바꾸면 항상 더 좋은 전달을 얻는다는 결론은 성립하지 않는다.
LoRA는 전달을 만들어내는 학습 수단인 동시에 업데이트 범위를 제한한다. 다만 low-rank라는 조건만으로 분포 유지가 자동 보장되는 것은 아니다. 적절한 학습 강도에 대한 체계적인 탐색은 남아 있다.
따로 학습한 능력을 함께 사용할 수 있는가
부록 C.5는 counting과 spatial relation의 understanding 데이터를 섞어 하나의 모델을 학습한다. 학습 sample 자체에는 두 능력을 동시에 요구하는 compositional 예시를 넣지 않는다.
이후 three cats are on the top-right of a sofa처럼 두 능력을 함께 요구하는 400 generation prompt로 평가한다.
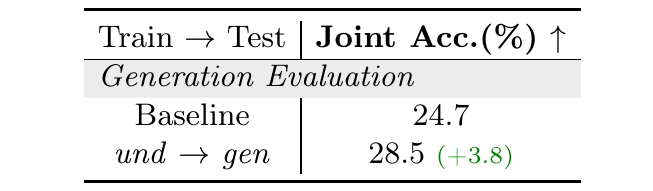
원문 Table 13의 joint accuracy는 개수와 위치 조건을 모두 만족하는 target object의 비율이다. Baseline 24.7% → 28.5%로 3.8 percentage point 개선된다.
이는 전달된 능력이 생성에서 조합될 수 있다는 초기 근거다. 그러나 최종 정확도는 여전히 28.5%이므로, 복잡한 compositional generation 문제가 해결되었다고 보기에는 부족하다.
Conclusion
이 논문은 UMM의 understanding과 generation을 같은 능력의 양쪽 사용 방식으로 바라본다. 한쪽 task에서만 능력을 추가 학습하고 다른 쪽에서 평가함으로써 capability-level transferability를 직접 관찰한다.
가장 강한 양방향 전달은 공유 transformer와 통합 이미지 표현을 가진 모델에서 나타난다. 이를 활용하면 generation을 직접 학습하지 않고 understanding supervision으로 counting이나 공간 관계를 보강할 수 있다.
핵심 이점은 목표 능력의 개선뿐 아니라 기존 생성 분포에서 덜 벗어난다는 것이다. 특히 합성 데이터의 배치 정보가 필요하지만 그 외형까지 생성하도록 학습하고 싶지 않을 때 유용한 선택지가 된다.
다만 전달의 크기와 방향은 task·모델·지표에 따라 다르다. Spatial accuracy는 직접 generation 학습이 더 높고, 문자에서는 전달이 약하거나 지표별로 다른 결과가 나타난다. Joint training에서도 두 task의 동시 개선은 보장되지 않는다.
Limitations
- 구조 비교의 범위: 본문은 네 대표 모델, 부록은 같은 계열 MMaDA를 추가한다. 모델별 pretrained 데이터와 objective가 다르므로 architecture만의 인과 효과를 분리한 결과는 아니다. 논문도 더 넓은 모델 비교가 필요하다고 밝힌다.
- Task-dependent transfer: 어떤 능력이 어느 방향으로 잘 전달될지 사전에 판단하는 원리는 아직 충분하지 않다. 세밀한 시각 정보가 중요하다는 해석은 유력한 설명이지만 확정된 법칙은 아니다.
- 평가 protocol의 범위: detector·OCR에 의존하는 생성 평가이며, spatial relation에서는 검출 실패 sample이 제외된다. 이미지 생성의 모든 실패를 포괄하는 지표로 읽지 않는다.
- 분포 유지와 품질의 차이: baseline 기준 FID가 낮으면 기존 분포와 가까운 것이다. Human preference나 photorealism의 개선을 그 수치 하나로 보장할 수 없다.
- 데이터와 post-training 조건: 대각선 합성 배치와 영어 H1 렌더링을 사용한 능력 보강 결과다. 자연 scene의 복잡한 관계, 조밀한 문서, 다른 문자 체계, 대규모 pre-training에서도 같은 효과가 날지는 추가 검증이 필요하다.
공유 representation을 가진 UMM에서 새로운 생성 능력을 보강하려면, 고품질 생성용 정답 이미지를 직접 학습하는 방법 외에도 그 능력을 읽어내는 understanding supervision을 활용할 수 있다는 점이 이 논문의 주요 결과다.