[Paper Review] UniCompress
[논문 리뷰] UniCompress: Token Compression for Unified Vision-Language Understanding and Generation
UniCompress: Token Compression for Unified Vision-Language Understanding and Generation
Ziyao Wang, Chen Chen, Jingtao Li, Weiming Zhuang, Jiabo Huang, Ang Li, Lingjuan Lyu
CVPR 2026
이 글의 방법·수치·그림은 제공된 arXiv v1을 기준으로 정리한다. 학회 정보는 CVF 공식 페이지에서 확인했다.
Background
Unified Multimodal Model에서 Image Token의 역할
Unified Multimodal Model(UMM)은 이미지 이해와 이미지 생성을 하나의 시스템에서 지원한다. 같은 모델에 사진을 넣고 내용을 물을 수도 있고, 텍스트로 원하는 장면을 설명해 이미지를 생성할 수도 있다.
여기서 understanding은 이미지에 관한 질문에 답하거나 caption을 작성하는 task이고, generation은 이미지 생성을 뜻한다. Understanding의 답변이 텍스트 생성으로 구현되더라도 두 task를 구분해서 부른다.
이미지를 LLM에서 처리하려면 먼저 encoder로 시각 representation을 얻어야 한다. Encoder가 이미지를 2차원 feature grid로 표현한다면, 이를 펼쳐 image token sequence로 만들 수 있다.
\[\mathbf{X}\in\mathbb{R}^{T\times d},\qquad T=H\times W\]- $\mathbf{X}$: encoder가 만든 연속적인 이미지 feature sequence
- $H,W$: feature grid의 높이와 너비. 원본 이미지의 pixel 크기와는 다르다.
- $T$: 전체 image token 수
- $d$: 각 token의 feature 차원
예를 들어 이미지가 $512\times512$이고 encoder의 공간 downsampling 배수가 16이면 feature grid는 $32\times32$, token 수는 1,024개가 된다. 이 예시는 논문 Introduction에서 이미지 sequence가 길어지는 이유를 설명하는 데 사용한다. 주요 비교 실험은 256개 image token을 사용하는 설정이다.
Understanding에서는 이 image token이 LLM의 입력 조건이 된다. Generation에서는 LLM이 image token을 출력으로 예측하고, image decoder가 이를 이미지로 변환한다. 같은 representation을 공유하더라도 입력을 짧게 만드는 문제와 생성해야 할 출력을 짧게 만드는 문제는 요구사항이 다르다.
Continuous Feature와 Discrete Image Token
연속 feature는 각 위치를 실수 벡터로 표현한다. 반면 discrete tokenizer는 feature를 codebook의 entry와 연결하여 정수 index로 표현한다.
Codebook을 여러 시각 패턴의 feature를 저장한 사전이라고 생각하면, quantization은 feature에 대응하는 사전 항목을 고르고 그 번호를 기록하는 과정이다. Dequantization은 번호를 이용해 해당 embedding을 다시 꺼내는 과정이다.
- Continuous representation: LLM의 hidden dimension에 맞게 projection하여 이미지 조건으로 전달할 수 있다.
- Discrete representation: image code를 vocabulary에 포함하면 LLM이 다음 token을 예측하는 방식으로 이미지를 생성할 수 있다.
Discrete index는 feature 자체가 아니다. 예를 들어 code 3과 code 9의 평균이 code 6에 해당하는 시각 패턴이라는 보장은 없다. 따라서 feature를 평균내는 연산과 정수 index를 평균내는 연산을 구별해야 한다.
UniCompress는 이 차이를 이용한다. 공통으로 압축한 연속 representation을 만들되, understanding에는 연속 feature를, generation의 학습 target에는 quantized code를 사용한다.
Understanding과 Generation은 무엇을 남겨야 하는가
“사진에 새가 있는가?”에 답할 때는 새를 알아볼 수 있는 의미 정보가 중요하다. 새 깃털의 모든 무늬를 정확히 표현할 필요는 없을 수 있다.
반면 새의 이미지를 생성하려면 객체의 존재뿐 아니라 몸의 형태, 배경과의 경계, 깃털의 texture, 전체 배치가 함께 자연스러워야 한다. 일부 token을 버린 뒤에도 caption을 작성할 수 있다는 사실만으로, 그 representation에서 좋은 이미지를 생성할 수 있다고 보장할 수 없다.
또한 이미지 token에는 공간 위치가 있다. 중요한 token만 선택하면 token 수는 줄지만, 원래 grid의 특정 위치가 빠지거나 이웃 관계가 불규칙해질 수 있다. 생성용 decoder에 다시 dense grid를 제공하려면 이 공간 구조를 어떻게 복원할지까지 설계해야 한다.
UniCompress는 여기서 정보를 두 종류로 나눈다.
- Local token: 각 공간 영역의 feature를 남겨 대략적인 위치와 배치를 보존한다.
- Global token: 압축 전 전체 feature를 읽어 장면 전반의 의미와 객체 관계를 보완한다.
Local stream을 줄이면서 global stream을 함께 남기고, 생성 시 이 둘을 조건으로 dense feature를 복원하는 것이 핵심이다.
UMM Transferability 리뷰가 공유 representation을 통한 능력 전달을 살펴봤다면, 이 논문은 두 task에서 사용할 representation을 얼마나 줄일 수 있는지 살펴본다. UniCompress의 실험은 압축 전후의 성능 비교이며, capability transfer를 직접 검증하는 실험은 아니다.
Introduction
이미지 token이 많아지면 LLM이 처리해야 할 sequence가 길어진다. Understanding에서는 이미지 입력을 읽는 비용이 늘고, autoregressive generation에서는 예측해야 할 image token 수가 늘어난다.
VLM의 이해 성능만 고려한다면 중요도가 낮은 token을 삭제하거나 여러 token을 합치는 방법을 사용할 수 있다. 그러나 UMM에는 같은 시각 representation으로 이미지를 생성해야 한다는 조건이 추가된다. 생성에 필요한 정보까지 버리면 LLM sequence는 짧아져도 출력 품질이 나빠질 수 있다.
논문은 기존 image tokenizer에 세 모듈을 추가한다. 전체 이미지를 읽는 global token extractor, local grid를 줄이는 average-pooling compressor, 생성 시 원래 grid로 되돌리는 autoregressive decompressor이다.
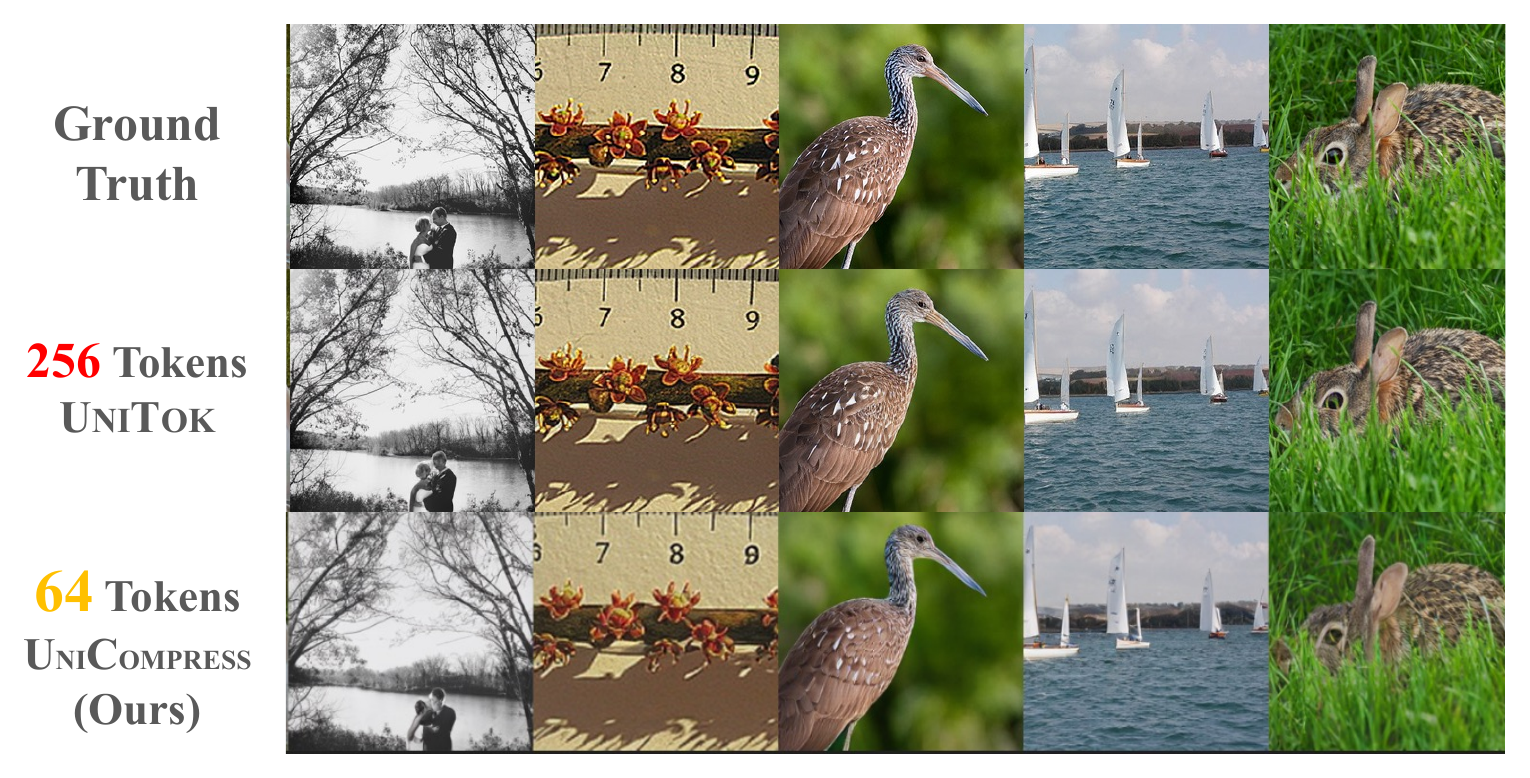
Figure 1은 원본 이미지와 두 representation에서 얻은 이미지를 비교한다. 적은 local token으로도 새, 배, 토끼 등 주요 객체와 배치를 남길 수 있다는 직관을 보여준다. 다만 나뭇가지나 깃털 등의 세부 표현은 달라지므로, 시각적으로 비슷하다는 사실을 손실 없는 복원으로 해석하면 안 된다.
그림의 64 Tokens는 local token 수이다. 기본 설정에는 global token 4개도 들어가므로 실제 visual representation은 68개이다. 이 개수는 Method에서 다시 구분한다.
Goal
기존 unified model의 인터페이스를 유지하면서, understanding과 generation에 함께 쓸 수 있는 짧은 시각 representation을 만드는 것이다. 압축 후에도 의미와 공간 구조를 가능한 한 유지하고, 특히 생성 과정의 실제 시간을 줄이는 것을 목표로 한다.
Motivation
- Understanding에 유효한 token selection이 generation의 세부정보 보존에도 유효하다고 보장할 수 없다.
- Tokenizer를 새로 교체하면 기존 unified model과의 연결 및 추가 학습이 필요하다. 기존 tokenizer의 feature·codebook·decoder를 활용할 수 있는 모듈 형태가 유용하다.
- Local pooling은 규칙적인 공간 grid를 유지하지만 정보 손실이 생긴다. 압축 전 전체 이미지를 읽는 global token과 학습된 복원 모듈로 이를 보완한다.
Contributions
- Global semantics와 압축된 local grid를 함께 사용하는 token compression 구조를 제안한다.
- 압축 representation을 이해 입력과 생성 target으로 활용하고, 생성에서는 autoregressive decompressor로 dense feature를 복원한다.
- 여러 unified model 계열에서 압축 전후 이해·생성 성능과 실제 시간을 비교하고, 압축률·pooling 방식·global token의 종류와 개수를 분석한다.
여기서 plug-in은 모듈식으로 통합할 수 있다는 의미다. 모듈을 삽입한 뒤 학습 없이 그대로 사용하는 방법은 아니다. Tokenizer 측 학습과 LLM의 추가 학습이 모두 필요하다.
Related Work
논문의 관련 연구는 무엇을 압축하고 어떤 인터페이스를 바꾸는지로 묶으면 이해하기 쉽다.
| 접근 | 줄이려는 대상 | Unified understanding/generation에서 확인할 점 |
|---|---|---|
| Token pruning·merging | VLM이 읽는 visual sequence | 이해 성능 외에 이미지 복원 가능성과 공간 구조가 남는지 |
| Compact image tokenizer | 이미지를 표현하는 latent/token 자체 | 기존 tokenizer와 decoder를 교체할 때 필요한 학습과 연결 비용 |
| Generation 효율화 | token 생성 순서·sampling·계산 | Understanding 입력에도 같은 representation을 사용할 수 있는지 |
| UniCompress | 기존 tokenizer의 feature sequence | Global/local 압축 표현을 두 task에 재사용하고 dense feature 복원 경로를 제공하는지 |
이 비교는 각 접근이 해결하려는 문제를 구분한 것이다. 모든 pruning 방법이 generation을 지원하지 못한다거나, 새로운 tokenizer가 항상 품질이 낮다는 의미는 아니다.
또한 주 실험은 다른 token compression 방법과의 광범위한 동일 조건 비교가 아니라, 각 unified model 계열의 baseline과 UniCompress를 추가한 variant 사이의 비교이다. 따라서 효율·품질의 변화는 확인할 수 있지만 모든 압축 방법 중 최선이라는 결론까지 나아가기는 어렵다.
Method
Pipeline Overview
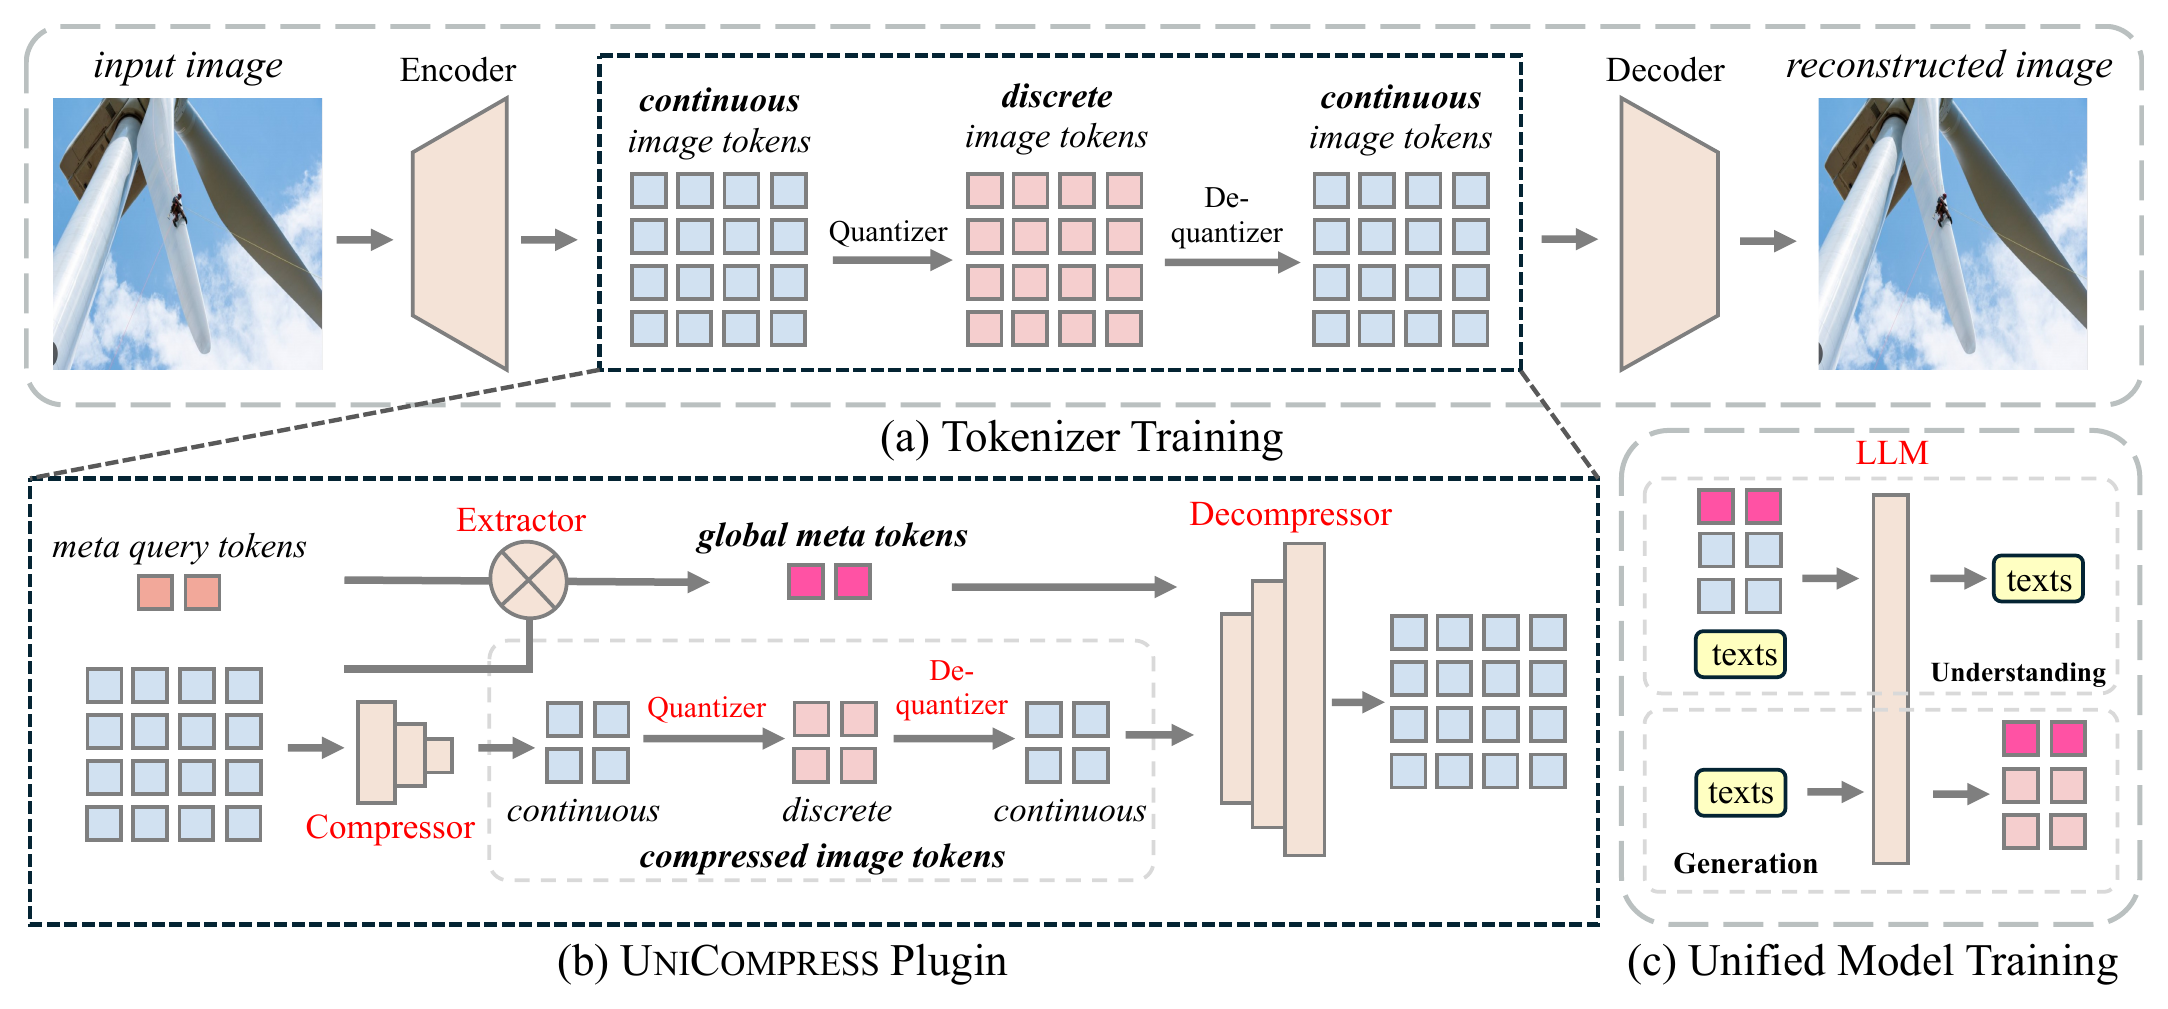
Figure 2의 (a)는 일반적인 tokenizer의 흐름이다. Encoder가 연속 feature를 만들고, quantization과 codebook lookup을 거쳐 image decoder가 이미지를 복원한다.
(b)는 중간 feature 경로에 추가되는 UniCompress 모듈이다. Dense image feature에서 두 경로가 갈라진다. 한쪽은 learnable query로 global token을 뽑고, 다른 쪽은 공간 pooling으로 local token을 줄인다. Decompressor는 이 둘을 이용하여 decoder가 기대하는 dense grid를 만든다.
(c)는 compact representation과 LLM의 연결이다. Understanding에서는 global/local feature와 텍스트를 넣어 텍스트를 출력한다. Generation에서는 텍스트를 조건으로 global/local image code를 출력한다.
따라서 전체 흐름은 다음과 같다.
- 압축 표현 준비: encoder output에서 global feature와 pooled local feature를 얻는다.
- Understanding: 두 feature를 LLM의 입력으로 사용하여 답변·caption을 만든다.
- Generation: LLM이 두 stream의 discrete code를 예측하고, dequantization→decompression→image decoder를 거쳐 이미지를 만든다.
Understanding에서 원래 크기의 image grid를 다시 만들 필요는 없다. Decompressor는 주로 이미지를 출력해야 하는 generation 경로에 필요하다.
Global Token Extraction: 압축 전 전체 이미지를 읽는다
Local pooling을 먼저 한 뒤 그 결과만 요약하면 이미 사라진 정보에 접근할 수 없다. UniCompress의 global extractor는 압축 전 dense feature $\mathbf{X}$를 읽는다.
이를 위해 작은 수의 learnable meta query를 둔다. Query가 전체 이미지 feature를 key/value로 삼아 cross-attention을 수행한다.
\[\mathbf{G}=\mathrm{MHA}\big(\mathbf{Q}W_Q,\ \mathbf{X}W_K,\ \mathbf{X}W_V\big) \tag{1}\]- $\mathbf{Q}\in\mathbb{R}^{N_g\times d}$: 학습 가능한 meta query. 학습된 parameter로서 이미지마다 공통으로 사용한다.
- $\mathbf{X}\in\mathbb{R}^{T\times d}$: 현재 이미지의 dense feature
- $\mathbf{G}\in\mathbb{R}^{N_g\times d}$: 현재 이미지에 따라 달라지는 global token
- $N_g$: global token 개수. 기본 설정은 4이다.
- $W_Q,W_K,W_V\in\mathbb{R}^{d\times d}$: query/key/value projection
- $\mathrm{MHA}$: multi-head attention
출력의 개수가 $N_g$인 이유는 query가 $N_g$개이기 때문이다. 각 query는 $T$개 이미지 위치를 attention으로 읽고, 그 정보를 하나의 feature로 모은다. 학습되는 query $\mathbf{Q}$와 이미지별 출력 $\mathbf{G}$를 같은 것으로 보면 안 된다.
이후 query branch에 residual connection과 layer normalization을 적용한다.
\[\mathbf{G}\leftarrow\mathrm{LN}(\mathbf{Q}+\mathbf{G}) \tag{2}\]- $\mathrm{LN}$: layer normalization
- $\mathbf{Q}+\mathbf{G}$: meta query의 residual을 더한 global feature
논문은 이를 one-way cross-attention이라고 부른다. Meta query가 이미지 feature를 읽어 global branch를 갱신하며, 이미지 feature 자체를 이 attention output으로 교체하지 않기 때문이다. 이것이 image encoder로의 gradient를 무조건 차단한다는 뜻은 아니다.
Global token에는 별도의 learned positional embedding을 사용한다. 여러 query가 서로 다른 정보를 읽도록 학습할 수 있지만, 각 query가 특정 객체나 고정된 의미 항목을 반드시 담당한다고 정의하지는 않는다.
Local Token Compression: 규칙적인 Grid를 줄인다
Local stream은 $T$개 feature를 원래 $H\times W$ grid로 되돌린 뒤, 겹치지 않는 영역에 average pooling을 적용한다.
\[\hat{\mathbf{X}}^{\mathrm{cont}}=\mathrm{AvgPool}(\mathbf{X},s),\qquad \tilde{T}=T/s^2 \tag{3}\]- $\hat{\mathbf{X}}^{\mathrm{cont}}\in\mathbb{R}^{\tilde{T}\times d}$: 압축된 연속 local feature
- $s$: 공간 축별 pooling 크기·stride
- $\tilde{T}$: 압축 후 local token 수
$s=2$이면 $2\times2$ 영역의 feature 4개를 하나로 합친다. 높이와 너비가 각각 절반이 되므로 token 수는 4분의 1이 된다. $s=4$이면 $4\times4$ 영역을 평균내므로 token 수는 16분의 1이다.
아래 식은 pooling을 공간 좌표로 풀어 쓴 설명용 식이다. Feature grid가 $s$로 나누어지는 경우 한 pooled token은 다음과 같다.
\[\hat{\mathbf{X}}^{\mathrm{cont}}_{a,b} =\frac{1}{s^2}\sum_{u=0}^{s-1}\sum_{v=0}^{s-1} \mathbf{X}_{sa+u,\,sb+v}\]- $a,b$: 압축 grid의 행·열 위치
- $u,v$: 하나의 pooling 영역 안의 상대 위치
- $\mathbf{X}_{sa+u,\,sb+v}$: 해당 위치의 $d$차원 feature vector
이 연산은 quantization 전 embedding에 적용한다. Integer code ID를 평균내는 것이 아니다. 영역의 평균을 유지하므로 local grid는 규칙적으로 남지만, 그 영역 안의 세부적인 차이는 합쳐진다.
평균낸 feature를 다시 늘리면 원본 정보가 돌아오는가?
네 feature의 평균이 같더라도 각각의 feature는 다를 수 있다. 첫 위치를 크게 하고 두 번째 위치를 같은 만큼 작게 해도 평균은 변하지 않는다. 따라서 평균 하나로 원래 네 feature를 유일하게 결정할 수 없다.
단순히 pooled feature를 네 위치에 복사하면 grid 크기는 되돌릴 수 있지만, 영역 내부의 차이는 새로 생기지 않는다. UniCompress가 learned decompressor를 두는 이유가 여기에 있다.
Global token은 pooling 전에 전체 이미지를 읽어 추가 정보를 남긴다. Decompressor는 이 정보와 local feature, 학습 중 익힌 시각 패턴을 이용해 dense feature를 예측한다. 하지만 global token도 유한한 크기의 압축 표현이므로 임의의 이미지를 정확히 역변환한다고 보장할 수 없다.
즉, 이 방법은 손실이 있는 압축에서 task에 필요한 정보를 유지하고 복원 품질을 높이는 방법으로 이해해야 한다.
Quantization과 Global-first Image Sequence
Generation에서는 LLM이 discrete image code를 예측해야 한다. 논문은 기존 quantizer를 이용하여 global feature와 pooled local feature를 codebook index로 바꾼다.
\[\hat{\mathbf{Z}}^{(g)}\in\{1,\ldots,K_g\}^{N_g},\qquad \hat{\mathbf{Z}}^{(x)}\in\{1,\ldots,K_x\}^{\tilde{T}} \tag{4}\]- $\hat{\mathbf{Z}}^{(g)}$: global stream의 discrete index sequence
- $\hat{\mathbf{Z}}^{(x)}$: local stream의 discrete index sequence
- $K_g,K_x$: 원문 식에서 global/local index 범위를 나타내는 표기
원문 식은 $K_g,K_x$로 구분하지만, 설명에서는 global/local에 같은 codebook을 사용한다고 명시한다. 이 표기를 근거로 별도 codebook 설계를 추가해서 해석하지 않는다.
Image sequence에는 시작·구분·종료 token이 들어간다. Global stream을 먼저 두고, local stream을 뒤에 둔다.
\[\texttt{[IMG\_BOS]},\; \hat{\mathbf{Z}}^{(g)}_{1:N_g},\; \texttt{[IMG\_SEP]},\; \hat{\mathbf{Z}}^{(x)}_{1:\tilde{T}},\; \texttt{[IMG\_EOS]} \tag{5}\]- $\texttt{[IMG_BOS]}$: image segment의 시작
- $\texttt{[IMG_SEP]}$: global stream과 local stream의 경계
- $\texttt{[IMG_EOS]}$: image segment의 종료
- $1:N_g$, $1:\tilde{T}$: 각 stream에 포함되는 index의 범위
Autoregressive LLM은 앞서 생성한 token을 조건으로 다음 token을 만든다. 따라서 이 순서에서는 local code를 생성할 때 이미 생성한 global code를 조건으로 볼 수 있다. Global과 local은 분리된 sequence 구간이지만, LLM 안에서는 앞뒤의 조건 관계로 연결된다.
Understanding의 일반적인 연결 방식은 모델 설계에 따라 연속·이산 representation 모두 가능하다고 설명한다. 다만 이 논문의 보고된 이해 실험은 quantization 없이 $\mathbf{G}$와 $\hat{\mathbf{X}}^{\mathrm{cont}}$를 직접 사용한다. 각 $d$차원 feature를 LLM의 hidden dimension에 맞게 linear projection하고, 같은 image delimiter로 구간을 구분한다.
4배 압축인데 왜 실제로는 64개보다 많은 token이 들어가는가?
4배는 local stream의 감소 배수이다. 실제 visual representation에는 global token이 추가된다. 다음은 원문 설정으로 계산한 token budget이다.
\[T_{\mathrm{visual}}=\frac{T}{s^2}+N_g =\frac{256}{2^2}+4=68\]- $T_{\mathrm{visual}}$: global과 local을 합친 visual token 수
- $T=256$: 압축 전 local image token 수
- $s=2$: $2\times2$ pooling
- $N_g=4$: 추가 global token 수
Local stream만 보면 $256/64=4$배 감소이다. Global을 포함한 visual token끼리 비교하면 $256/68\approx3.76$배이다. 시작·구분·종료 token 3개까지 포함한 image segment는 71개가 된다.
다만 전체 LLM sequence에는 텍스트 token도 들어간다. 또한 압축 전 모델의 image delimiter 개수를 함께 고려해야 한다. 따라서 전체 입력 길이나 실제 실행 시간이 모두 정확히 4분의 1이 된다고 해석하지 않는다.
Autoregressive Decompression: 짧은 표현에서 Dense Feature로
Generation 중 LLM이 예측한 것은 global/local의 discrete index이다. 이를 image decoder에 바로 넣는 대신, 먼저 codebook lookup으로 연속 feature를 얻는다.
\[\hat{\mathbf{G}}=\mathcal{E}\big(\hat{\mathbf{Z}}^{(g)}\big),\qquad \hat{\mathbf{X}}^{\mathrm{deq}}=\mathcal{E}\big(\hat{\mathbf{Z}}^{(x)}\big) \tag{6}\]- $\mathcal{E}$: codebook index를 embedding으로 바꾸는 lookup
- $\hat{\mathbf{G}}\in\mathbb{R}^{N_g\times d}$: dequantization 후 global feature
- $\hat{\mathbf{X}}^{\mathrm{deq}}\in\mathbb{R}^{\tilde{T}\times d}$: dequantization 후 local feature
Lookup은 선택된 codebook embedding을 꺼내는 과정이다. Quantization 전 feature와 정확히 같은 값을 복구하는 과정은 아니다.
Decompressor는 이 두 feature를 조건으로, 원래 image decoder가 기대하는 $T$개 dense feature를 예측한다. 구현은 Transformer decoder이며, 이전에 만든 dense feature에는 masked self-attention, 압축된 global/local feature에는 cross-attention을 적용한다.
\[\mathbf{x}_t=f_{\mathrm{dec}}\big( \mathbf{X}^{\mathrm{dense}}_{<t},\; \hat{\mathbf{X}}^{\mathrm{deq}},\; \hat{\mathbf{G}}\big) \tag{7}\]- $f_{\mathrm{dec}}$: autoregressive decompressor
- $\mathbf{x}_t\in\mathbb{R}^{d}$: dense grid의 $t$번째 연속 feature
- $\mathbf{X}^{\mathrm{dense}}_{<t}$: 앞서 생성한 dense feature sequence
- $t$: grid를 raster order로 펼쳤을 때의 생성 위치
- $\hat{\mathbf{X}}^{\mathrm{deq}},\hat{\mathbf{G}}$: 매 layer에서 참조하는 압축 조건
Raster order는 grid를 일정한 행·열 순서로 읽는 방식이다. Causal mask를 사용하므로 현재 위치는 아직 생성하지 않은 뒤쪽 dense feature를 볼 수 없다. 대신 이미 만든 feature와 compact representation을 보면서 다음 feature를 예측한다.
이렇게 $T$개 feature를 만든 뒤 원래 grid 형태로 배치하여 image decoder로 보낸다. Decompressor의 출력은 discrete code ID가 아니라 연속 feature이다. 여기서 “원래 resolution으로 복원”은 먼저 tokenizer feature grid의 resolution을 의미하고, 최종 pixel 이미지는 image decoder가 만든다.
Decompressor도 autoregressive라면 생성 단계가 줄지 않는 것 아닌가?
두 autoregressive 과정을 구분해야 한다.
- LLM: 텍스트를 조건으로 $N_g+\tilde{T}$개의 compact image code를 예측한다.
- Decompressor: compact feature를 조건으로 $T$개의 dense continuous feature를 예측한다.
Dense grid의 $T$개 위치를 만드는 작업 자체가 없어지는 것은 아니다. 큰 language backbone이 긴 image sequence를 직접 생성하던 부담의 일부를 tokenizer 측 복원 모듈로 옮기는 것이다.
LLM에서 처리하는 image token 수는 줄지만 global extractor, codebook lookup, decompressor, image decoder의 비용은 남는다. 때문에 local token 4배 감소만으로 전체 latency 4배 개선을 예측할 수 없다. 실제 Table 3의 생성 시간 감소는 약 41%이다.
또한 논문은 decompressor의 구체적인 layer 수·parameter 수·단독 시간을 제시하지 않는다. “Lightweight”라는 설명만으로 각 모듈의 비용 비율까지 계산할 수는 없다.
Training: 압축·복원 학습과 LLM 적응을 분리한다
Stage 1: Tokenizer-side Training
먼저 LLM을 freeze하고 tokenizer 측 압축·복원 경로를 학습한다. Dense encoder feature $\mathbf{X}$에서 compact representation을 만들고, decompressor가 이를 dense feature로 복원하도록 학습한다.
학습에는 teacher forcing을 사용한다. $t$번째 dense feature를 예측할 때 앞쪽의 정답 dense feature를 prefix로 제공한다. 반면 추론에서는 앞서 스스로 예측한 feature를 prefix로 사용한다.
Reconstruction objective는 다음과 같다.
\[\mathcal{L}_{\mathrm{recon}} =\mathcal{L}_{\mathrm{reg}} +\lambda_{\mathrm{cb}}\mathcal{L}_{\mathrm{cb}} \tag{8}\]- $\mathcal{L}_{\mathrm{recon}}$: tokenizer 측 압축·복원 학습 objective
- $\mathcal{L}_{\mathrm{reg}}$: dense feature 공간에서 정답 feature를 맞추는 token-level regression term
- $\mathcal{L}_{\mathrm{cb}}$: codebook consistency term
- $\lambda_{\mathrm{cb}}$: codebook term의 가중치
학습 대상 stack에는 learnable global extractor, codebook, decompressor가 포함된다. Average pooling은 고정된 평균 연산이므로 pooling 자체에는 학습 parameter가 없다.
이 식의 regression norm, codebook loss의 구체적인 형태, $\lambda_{\mathrm{cb}}$ 값은 본문에서 충분히 제시하지 않는다. 또한 기존 encoder·image decoder의 어느 부분까지 freeze하는지도 명확히 구분하지 않는다. 따라서 이 부분을 특정 VQ loss나 encoder freeze 설정으로 확정해서 읽지는 않는다.
Stage 2: LLM Training
두 번째 단계에서는 tokenizer stack을 freeze하고 LLM을 compact representation에 맞춰 학습한다.
- Understanding: global/local continuous feature와 질문·텍스트를 조건으로 답변을 학습한다.
- Generation: 텍스트를 조건으로 global/local discrete image code를 autoregressive하게 학습한다.
Generation target이 원래 dense image sequence에서 compact sequence로 바뀌었으므로 LLM도 새 representation의 순서와 의미를 배워야 한다. 이 단계가 있기 때문에 “LLM을 유지한다”는 표현은 architecture와 인터페이스를 재사용한다는 의미로 이해해야 한다. 전체 과정에서 LLM weight가 계속 고정된다는 뜻은 아니다.
Inference: 두 Task의 경로
| 단계 | Understanding | Image Generation |
|---|---|---|
| 조건 | 이미지와 질문·텍스트 | 생성할 장면을 설명하는 텍스트 |
| Compact representation | encoder→global extraction/local pooling | LLM이 global code→local code 순으로 예측 |
| LLM의 시각 정보 | projection한 continuous feature를 입력으로 읽음 | discrete image code를 출력으로 생성 |
| Dense decompression | 필요하지 않음 | codebook lookup→AR decompressor |
| 최종 출력 | 텍스트 답변·caption | dense feature→image decoder→이미지 |
이 표는 논문이 자세히 설명하는 autoregressive image-token 경로를 정리한 것이다. OpenUni·BAGEL처럼 diffusion module을 사용하는 확장에서는 입력·출력 크기에 맞춰 compression scheme을 조정한다고 하지만, 세부 변환은 충분히 설명하지 않는다. 모든 diffusion variant가 이 discrete code 생성 과정을 그대로 사용한다고 일반화하지 않는다.
Experiments
Experimental Setup: 무엇을 같은 조건으로 비교했는가
비교 대상은 UniTok, VILA-U, VARGPT, UniFork, OpenUni, BAGEL의 여섯 계열이다. 앞의 세 계열은 understanding과 generation에 하나의 image tokenizer를 사용하는 구조로, 논문의 주요 대상이다. UniFork는 task별 tokenizer가 다른 경우, OpenUni·BAGEL은 diffusion module을 포함하는 경우의 확장이다.
중요한 조건은 language backbone을 Llama-3.2-1B로 맞춘 실험이라는 점이다. 표의 모델 이름을 각 논문이 공개한 원래 크기의 checkpoint와 그 성적으로 읽으면 안 된다.
각 계열에서 baseline과 UniCompress를 추가한 compressed variant를 비교한다. 주요 설정은 다음과 같다.
- Diffusion 계열을 제외한 기본 image token budget은 256개이다.
- Pooling stride는 $s=2$, global token은 $N_g=4$이다. Local 64개와 global 4개를 사용한다.
- Pre-training은 generation용 JourneyDB(JDB)와 understanding용 ShareGPT4V_PT를 함께 사용해 1 epoch 수행한다. Accumulated batch size는 128, learning rate는 $5\times10^{-5}$이다.
- 이후 ShareGPT4V로 1 epoch fine-tuning한다. Accumulated batch size는 256, learning rate는 $10^{-4}$이다.
- 부록의 실험 서버는 Ubuntu 22.04, Xeon Platinum 8468V, H100 80GB 8개이다.
Non-diffusion 계열의 generation 비교는 guidance, step 수, temperature 등 sampling 조건을 맞춘다고 설명한다. 다만 각 값과 Stage 1의 별도 학습 비용까지 상세히 보고하지는 않는다.
Metrics: 이해 정확도와 생성 품질을 분리해서 본다
Understanding은 GQA, MME Cognition, MME, POPE, Seed-bench, TextVQA, MMMU, MM-Bench를 사용한다. 모두 높은 값이 좋은 방향이지만, MME 계열의 원점수와 다른 benchmark의 정확도는 같은 단위가 아니다. 정확도가 55.71에서 53.07로 바뀌었다면 2.64 percentage point(pp) 하락으로 적는다.
Generation은 MJHQ-30K에서 두 지표를 보고한다.
- FID ↓: 생성 이미지와 실제 이미지의 Inception feature 분포를 비교한다. 분포의 평균·공분산 차이를 반영하며, 낮을수록 좋다.
- CLIP ↑: 텍스트와 이미지 embedding의 정렬 정도를 평가한다. 높을수록 prompt와 생성 이미지가 더 잘 연결된다. 여기서는 표에 보고된 scale을 그대로 사용한다.
FID는 개별 이미지가 원본과 pixel 단위로 얼마나 같은지 측정하는 지표가 아니다. 또 FID 변화가 작더라도 CLIP이 크게 떨어질 수 있다. 자연스러운 이미지 분포에 가깝다는 것과 주어진 텍스트 내용을 잘 따르는 것은 다른 조건이기 때문이다.
Visual Understanding: 유지되는 성능과 떨어지는 성능
먼저 local token을 4분의 1로 줄였을 때 이미지에서 정보를 읽는 능력이 얼마나 유지되는지 확인한다.
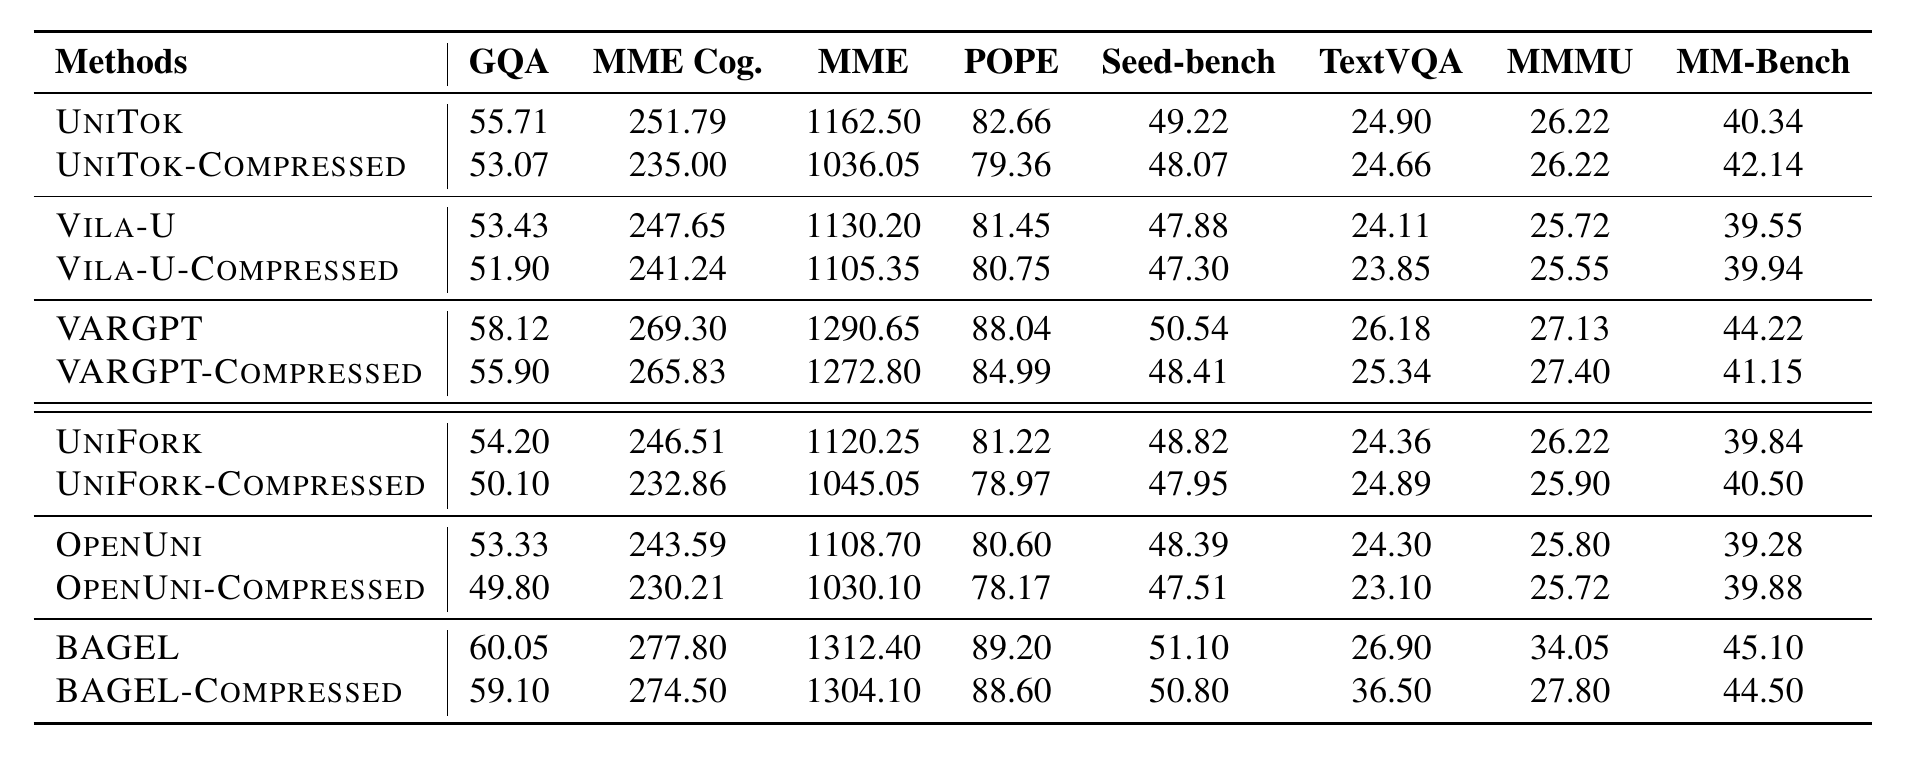
Table 1에서는 같은 계열의 위·아래 행을 비교한다. UniTok의 주요 변화는 다음과 같다.
- GQA: $55.71\rightarrow53.07$, 2.64pp 하락
- POPE: $82.66\rightarrow79.36$, 3.30pp 하락
- TextVQA: $24.90\rightarrow24.66$, 0.24pp 하락
- MMMU: $26.22\rightarrow26.22$, 동일
- MM-Bench: $40.34\rightarrow42.14$, 1.80pp 상승
- MME: $1162.50\rightarrow1036.05$, 원점수 126.45 하락
따라서 짧은 representation으로도 일부 이해 benchmark는 비슷하게 유지되지만, 모든 지표의 손실이 작지는 않다. 특히 MME의 변화는 정확도 0.몇 pp 하락과 같은 크기의 변화로 취급할 수 없다.
VILA-U는 GQA가 1.53pp, POPE가 0.70pp 하락하고 MM-Bench는 0.39pp 상승하여 비교적 작은 변화가 나타난다. VARGPT는 GQA 2.22pp, POPE 3.05pp, MM-Bench 3.07pp 하락으로 task별 차이가 있다.
다른 구조에서도 압축 variant를 학습할 수는 있지만 성능 유지 정도는 다르다. UniFork의 GQA는 4.10pp, OpenUni의 GQA는 3.53pp 하락한다. BAGEL은 GQA·POPE·Seed-bench 변화가 작은 반면, MMMU는 $34.05\rightarrow27.80$으로 6.25pp 하락한다.
Table 1의 BAGEL TextVQA는 $26.90\rightarrow36.50$으로 큰 상승이 적혀 있다. 이는 원문 표의 값이며, 압축만으로 해당 능력이 크게 개선되었다는 원인 분석은 제시되지 않는다. 일부 상승을 전체 성능 향상으로 일반화하지 않는다.
이 결과는 “압축 표현으로도 다양한 이해 task가 가능하다”는 근거가 된다. 하지만 모든 모델·task에서 손실이 3point 이내이거나 거의 없다는 결론은 표와 맞지 않는다.
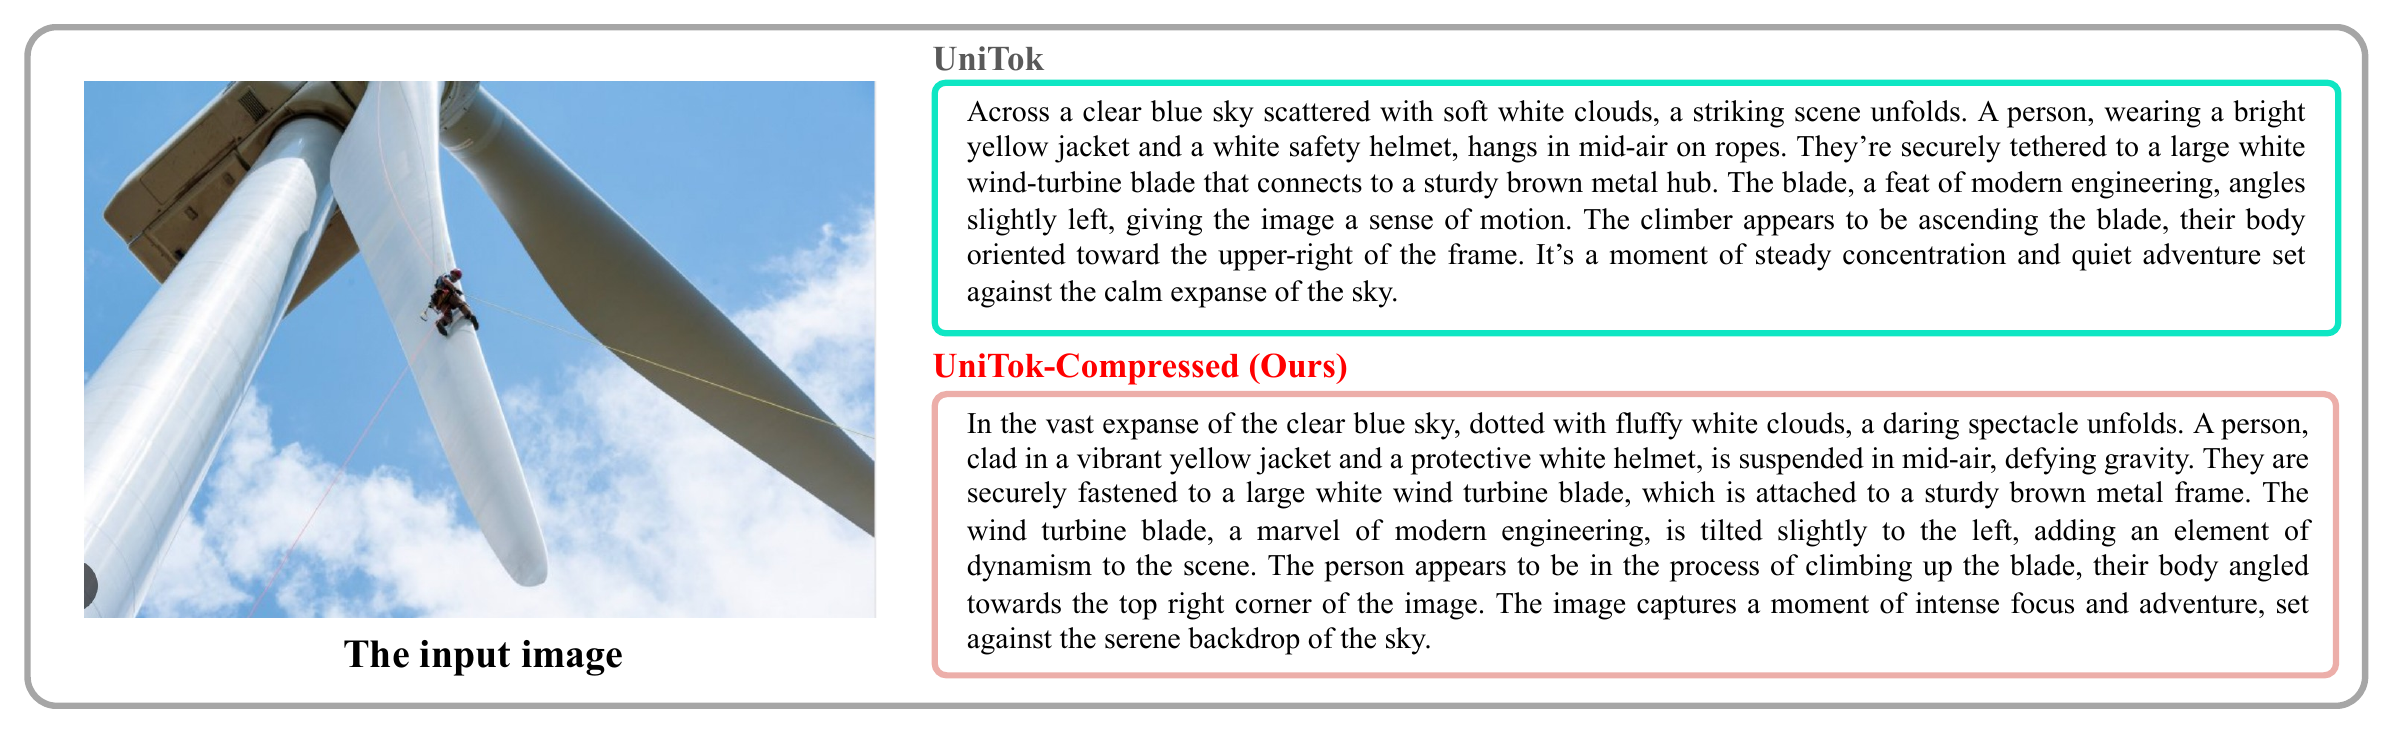
Figure 3은 풍력 터빈에 매달린 사람의 이미지를 설명한 예시다. 두 caption 모두 사람, 흰색 풍력 터빈, 파란 하늘과 사람의 행동을 서술한다. 압축 representation에서도 주요 객체와 관계를 읽을 수 있음을 보여준다.
다만 두 caption은 긴 묘사를 포함한 정성적 예시다. 모든 세부 속성이 정확하다는 annotation이나 별도 정량 평가가 없으므로, 이 한 예시만으로 세밀한 위치·복장·동작 정보까지 완전히 보존되었다고 판단하지 않는다.
Image Generation: FID가 유지되어도 Text Alignment는 달라진다
다음으로 compact image code에서 생성한 이미지의 분포 품질과 text alignment가 어떻게 바뀌는지 확인한다.
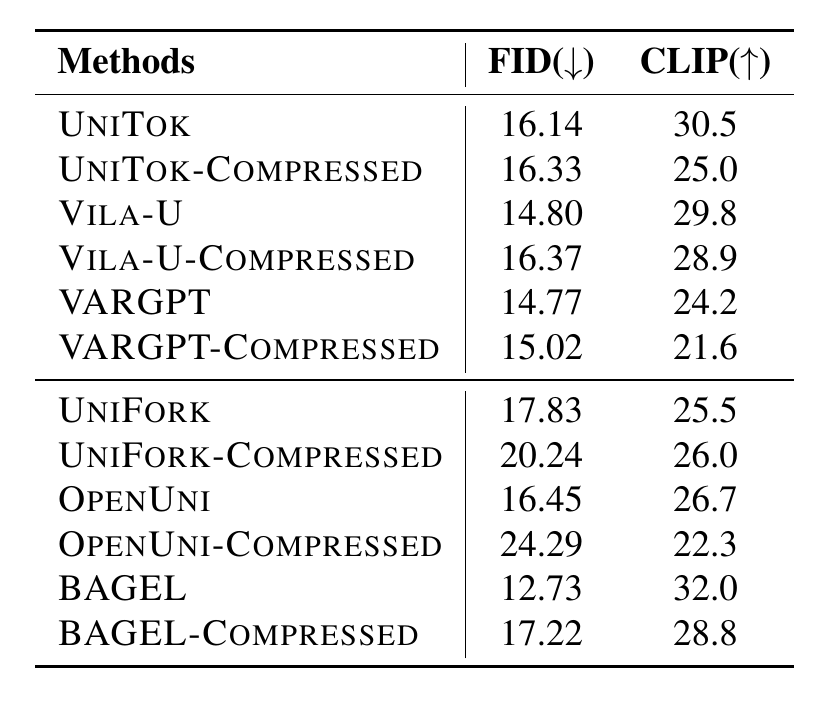
UniTok의 FID는 $16.14\rightarrow16.33$으로 0.19 증가한다. 그러나 CLIP은 $30.5\rightarrow25.0$으로 5.5 낮아진다. 이미지 분포의 품질 변화가 작다고 해서 prompt alignment 손실도 작다고 볼 수는 없다.
VILA-U는 FID가 $14.80\rightarrow16.37$, CLIP이 $29.8\rightarrow28.9$로 비교적 완만하게 바뀐다. VARGPT는 FID 변화가 $14.77\rightarrow15.02$로 작지만 CLIP은 $24.2\rightarrow21.6$으로 낮아진다.
UniFork는 FID가 $17.83\rightarrow20.24$로 나빠지는 동시에 CLIP은 $25.5\rightarrow26.0$으로 조금 높아진다. 이 사례도 두 metric이 같은 성질을 측정하지 않는다는 점을 보여준다.
Diffusion을 포함한 두 계열의 손실은 더 크다.
- OpenUni: FID $16.45\rightarrow24.29$, CLIP $26.7\rightarrow22.3$. FID가 7.84 증가하여 이 표에서 가장 큰 저하가 나타난다.
- BAGEL: FID $12.73\rightarrow17.22$, CLIP $32.0\rightarrow28.8$. Baseline의 좋은 품질에 비해 압축 손실이 남는다.
따라서 이 실험에서는 일부 계열이 압축에 비교적 잘 견디지만, 모든 구조에서 동일한 품질을 유지하지는 않는다. 특히 diffusion 확장의 상세 scheme이 부족하므로, 이 결과만으로 손실의 원인이 특정 모듈에 있다고 확정하기는 어렵다.
원문 §4.3의 UniTok-Compressed CLIP은 22.0으로 적혀 있지만 Table 2에는 25.0으로 적혀 있다. 위 설명은 표의 25.0을 기준으로 한다. 또한 “FID 손실이 최대 5”라는 요약은 OpenUni의 7.84 증가를 포함하지 못한다.
Efficiency: Generation의 시간 감소가 크다
Token 수 감소가 실제 학습·추론 시간의 감소로 이어지는지 task별로 비교한다.
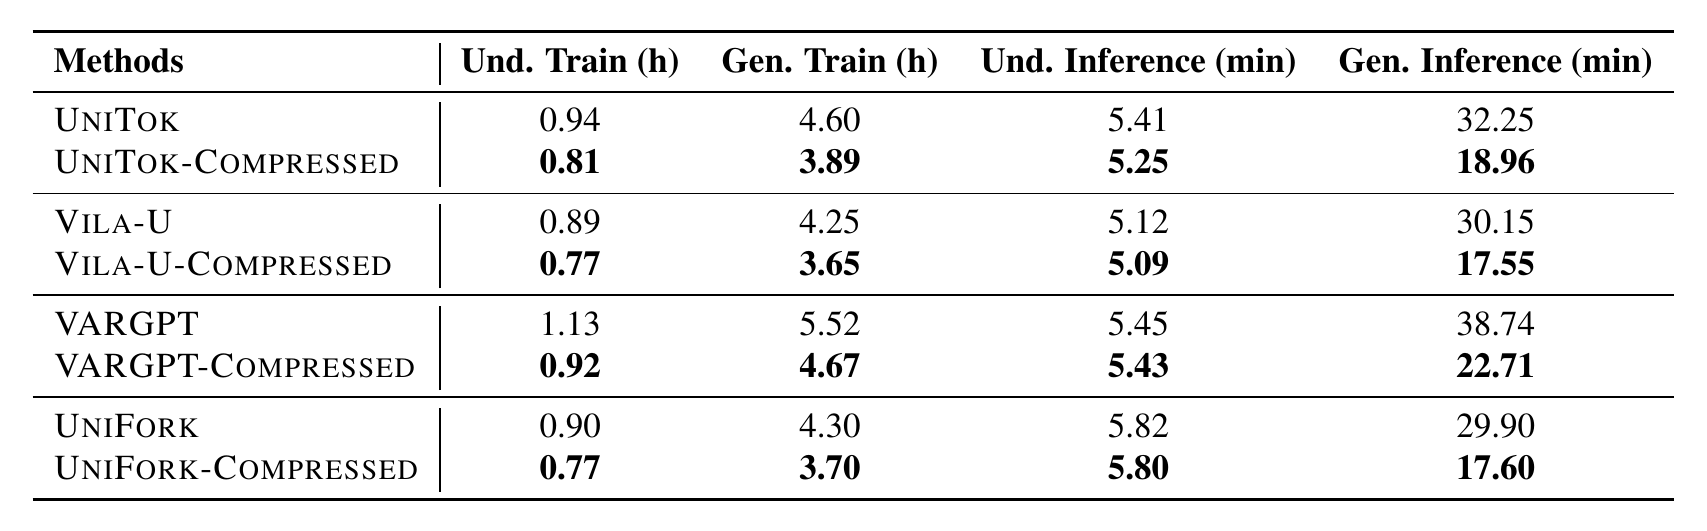
Table 3의 학습 단위는 hour, 추론 단위는 minute이다. Understanding은 ShareGPT4V_PT 학습과 GQA 추론, generation은 JDB 학습과 MJHQ-30K 추론으로 측정한다.
다른 실험에서는 두 dataset을 섞어 학습하지만, 이 표의 학습 시간은 각 dataset을 별도로 학습하여 측정한 값이다. 추론 시간 역시 평가 workload의 전체 시간이므로 한 이미지나 한 질문의 응답 시간으로 읽으면 안 된다.
시간 감소율은 다음처럼 계산한다. 아래 식은 표의 값으로 변화를 해석하기 위한 계산이다.
\[\mathrm{Time\ Reduction} =\frac{t_{\mathrm{base}}-t_{\mathrm{comp}}}{t_{\mathrm{base}}}\times100\%\]- $t_{\mathrm{base}}$: baseline의 실행 시간
- $t_{\mathrm{comp}}$: compressed variant의 실행 시간
Generation 추론의 변화는 다음과 같다.
| 계열 | Baseline → Compressed | 시간 감소율 |
|---|---|---|
| UniTok | 32.25 → 18.96 min | 약 41.2% |
| VILA-U | 30.15 → 17.55 min | 약 41.8% |
| VARGPT | 38.74 → 22.71 min | 약 41.4% |
| UniFork | 29.90 → 17.60 min | 약 41.1% |
UniTok의 실행 시간 비율은 $32.25/18.96\approx1.70$이다. 즉, 같은 workload를 약 1.70배 빠르게 처리한 결과다. 41% 적은 시간, 1.70배 속도, 4배 local token 감소는 서로 다른 값이다.
반면 understanding 추론의 변화는 작다. UniTok은 $5.41\rightarrow5.25$분으로 약 3.0% 감소하고, VILA-U·VARGPT·UniFork는 각각 약 0.6%, 0.4%, 0.3% 감소한다. 따라서 이 표에서 가장 뚜렷한 이득은 autoregressive image generation에 있다.
Generation 학습 시간은 약 14.0–15.4% 줄어든다. Understanding 학습도 줄며, VARGPT는 $1.13\rightarrow0.92$시간으로 약 18.6% 감소한다.
LLM이 이미지 code를 덜 예측한다는 구조적 설명은 생성의 시간 감소와 연결된다. 다만 구체적인 FLOPs·메모리 사용량·모듈별 시간은 보고되지 않는다. Tokenizer의 추가 학습까지 합한 전체 개발 비용도 이 표에서 분리해 확인할 수 없다. 또한 H100 서버 실측이므로 저사양 기기에서도 같은 배속이 나온다고 보장하지 않는다.
Ablation: 얼마나 압축할 수 있는가
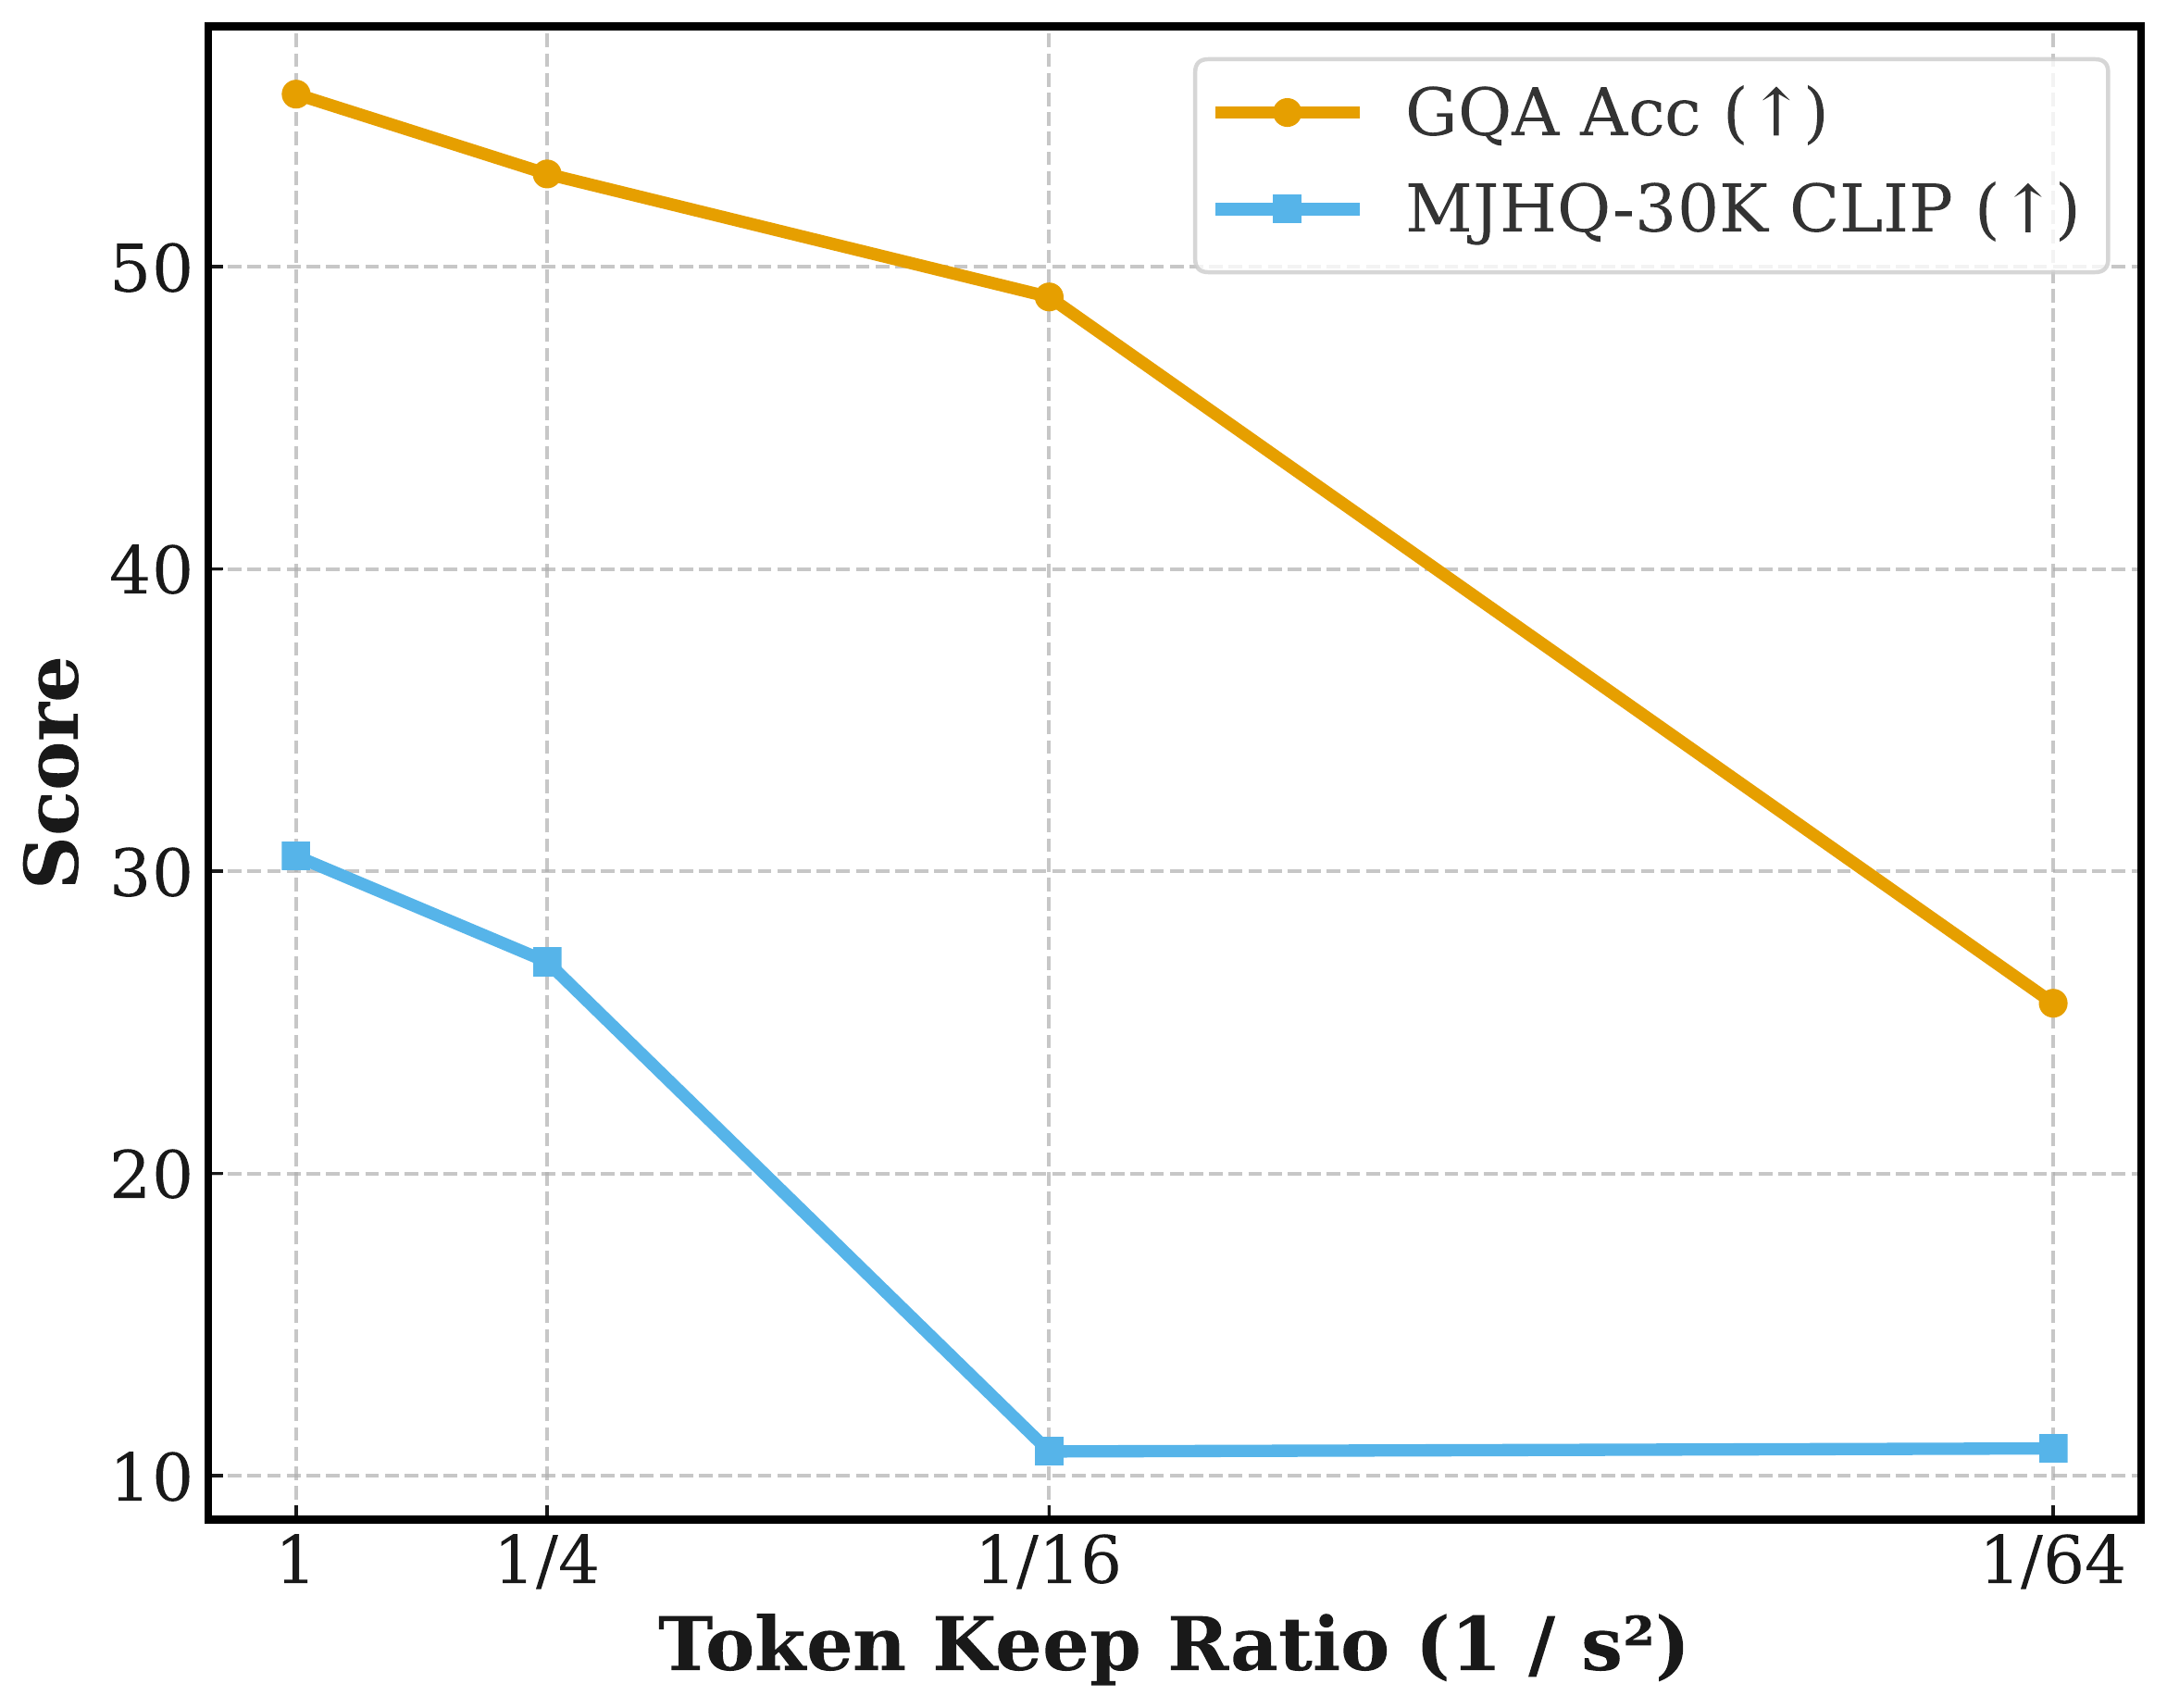
Figure 6은 local token keep ratio $1/s^2$를 바꾼다. $s=1,2,4,8$에 따라 local token이 원래의 $1,1/4,1/16,1/64$만큼 남는다.
Keep ratio가 $1/16$일 때 GQA는 55.71에서 49.00으로 떨어진다. CLIP은 30.5에서 약 11로 크게 낮아진다. Generation에서 text-image alignment가 더 빠르게 악화되는 모습을 확인할 수 있다. $1/64$에서는 GQA도 크게 하락하여 understanding 역시 무한히 압축에 견디지는 못한다.
이 실험은 기본 $1/4$ 설정을 선택한 이유를 뒷받침한다. 더 적은 token을 사용하는 것 자체가 목적이라면 강하게 압축할 수 있지만, 이해와 생성을 함께 유지하려면 generation의 정보 요구량까지 고려해야 한다.
이 그래프의 두 선은 서로 다른 metric이다. 선의 높이를 직접 비교하여 “이해 능력이 생성 능력의 두 배”처럼 해석하지 않고, 각 metric의 압축 전후 변화를 본다.
Ablation: Average Pooling을 선택한 이유
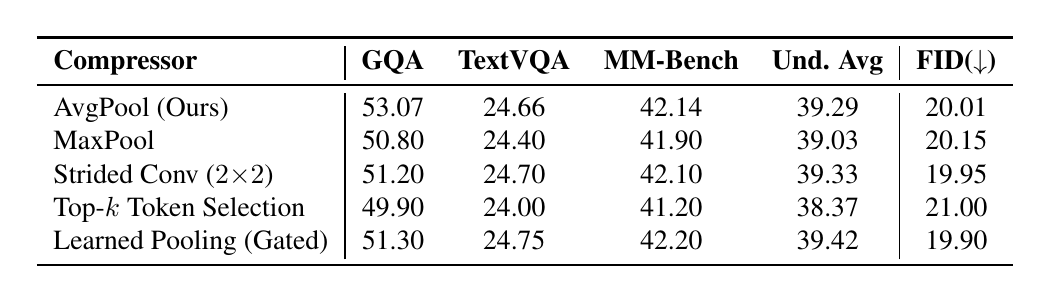
Table 4는 $s=2$, $N_g=4$ 조건에서 local compressor를 바꾼다. 모두 같은 local token budget을 목표로 한다.
AvgPool은 GQA 53.07로 이 표에서 가장 높다. Top-$k$ selection은 GQA 49.90, FID 21.00으로 AvgPool의 53.07, 20.01보다 낮은 결과를 보인다. 단순히 중요한 위치를 선택하는 것보다 규칙적인 영역 정보를 모으는 방식이 이 설정에서는 유리하다.
그러나 AvgPool이 모든 지표에서 최고는 아니다. Learned Pooling은 TextVQA 24.75, MM-Bench 42.20, FID 19.90으로 AvgPool보다 조금 좋다. Strided convolution도 FID 19.95를 얻는다.
따라서 average pooling의 장점은 추가 pooling parameter 없이 단순하게 공간 grid를 줄이고, 경쟁력 있는 결과를 얻는다는 것이다. Learned compressor가 전혀 도움이 안 된다는 결론은 아니다.
Table 4의 평균값과 Main Table의 FID를 그대로 연결하면 안 되는 이유
AvgPool 행의 GQA·TextVQA·MM-Bench는 53.07, 24.66, 42.14이다. 이 세 수의 산술평균은 약 39.96이지만, 표의 Und. Avg는 39.29로 적혀 있다. 다른 평균 정의나 오기 여부를 확인할 충분한 설명이 없어 이 열을 근거로 종합 우위를 주장하지 않는다.
또한 AvgPool의 FID는 Table 4에서 20.01이고, UniTok-Compressed의 FID는 Main Table 2에서 16.33이다. 두 실험을 정확히 연결하는 조건이 충분히 제시되지 않는다. Global token 관련 ablation도 FID 약 20의 결과를 사용한다.
따라서 main results는 main table 안에서, pooling/global ablation은 해당 비교 안에서 읽는다. 서로 다른 표의 값을 붙여 특정 모듈 하나가 FID를 16.33에서 20.01로 바꿨다고 해석하지 않는다.
Ablation: 어떤 Global Information을 남길 것인가
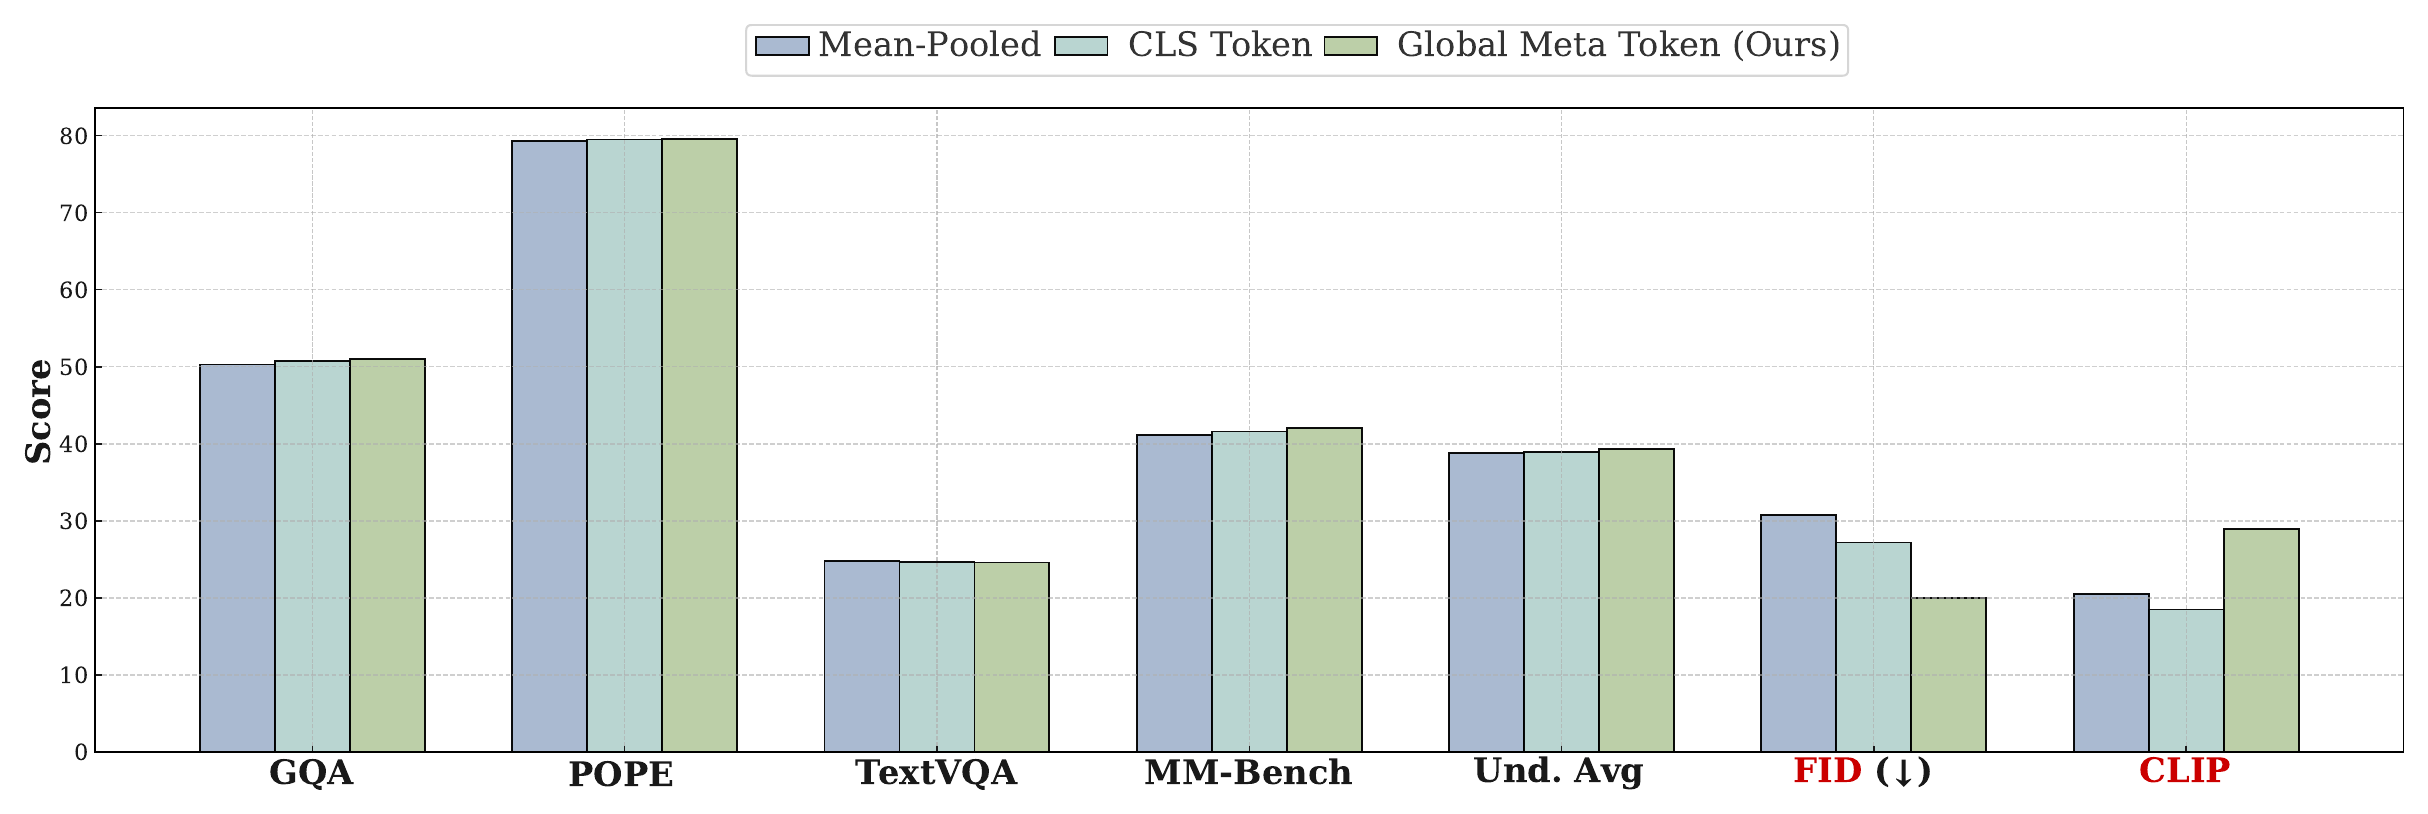
Figure 4는 $N_g=4$ 조건에서 global representation을 만드는 방식을 비교한다. 전체 image feature를 평균낸 방식, ViT의 CLS token을 사용하는 방식, learnable query로 읽는 방식이다.
Understanding 지표에서는 세 방식의 차이가 비교적 작다. 하지만 generation에서는 learnable global meta token의 FID가 더 낮고 CLIP이 더 높다. Global 정보를 어떤 방식으로 요약하느냐가 생성에서 더 큰 차이를 만든다는 결과다.
Mean pooling은 모든 위치를 같은 비중으로 합친다. Query-based extraction은 학습된 attention으로 위치별 정보를 다르게 읽을 수 있다. 논문은 이것이 decompressor에 더 유용한 image-specific condition을 준다고 해석한다. 다만 이 해석을 각 query의 의미가 직접 밝혀졌다는 분석으로 확대하지는 않는다.
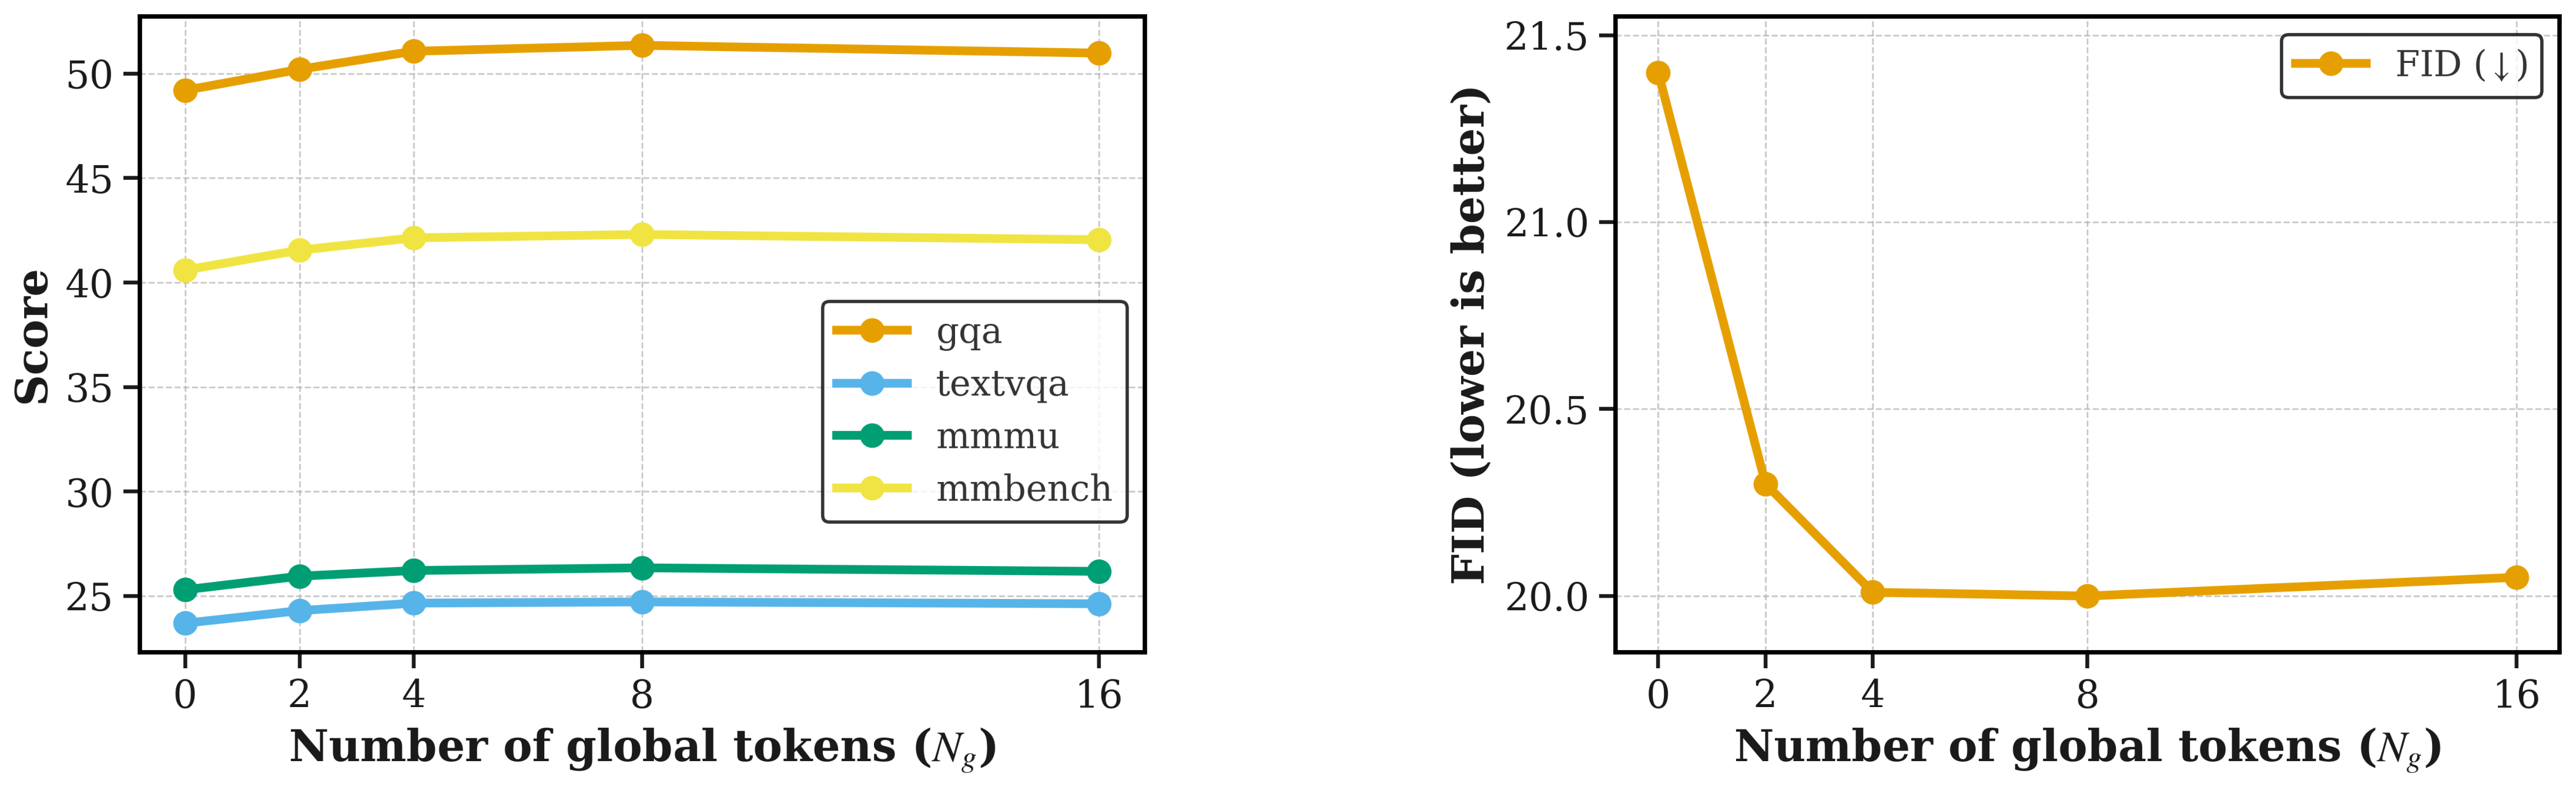
부록 Figure 7에서는 global token을 없앴을 때 FID가 약 21.4로 높고, 4개를 넣으면 약 20.01로 낮아진다. 8개에서는 약 20.00으로 4개와 거의 같다. Understanding 지표도 4개 이후 개선이 작고, 16개로 늘린다고 계속 좋아지지는 않는다.
Global token은 추가 정보이지만 LLM sequence에 포함되는 비용도 있다. 이 결과에 따라 논문은 $N_g=4$를 정보 보완과 token overhead 사이의 절충으로 선택한다. 모든 이미지 resolution이나 모델에서 반드시 4개가 최적이라는 의미는 아니다.
Ablation: Global Token과 AR Decompressor가 복원에 주는 효과
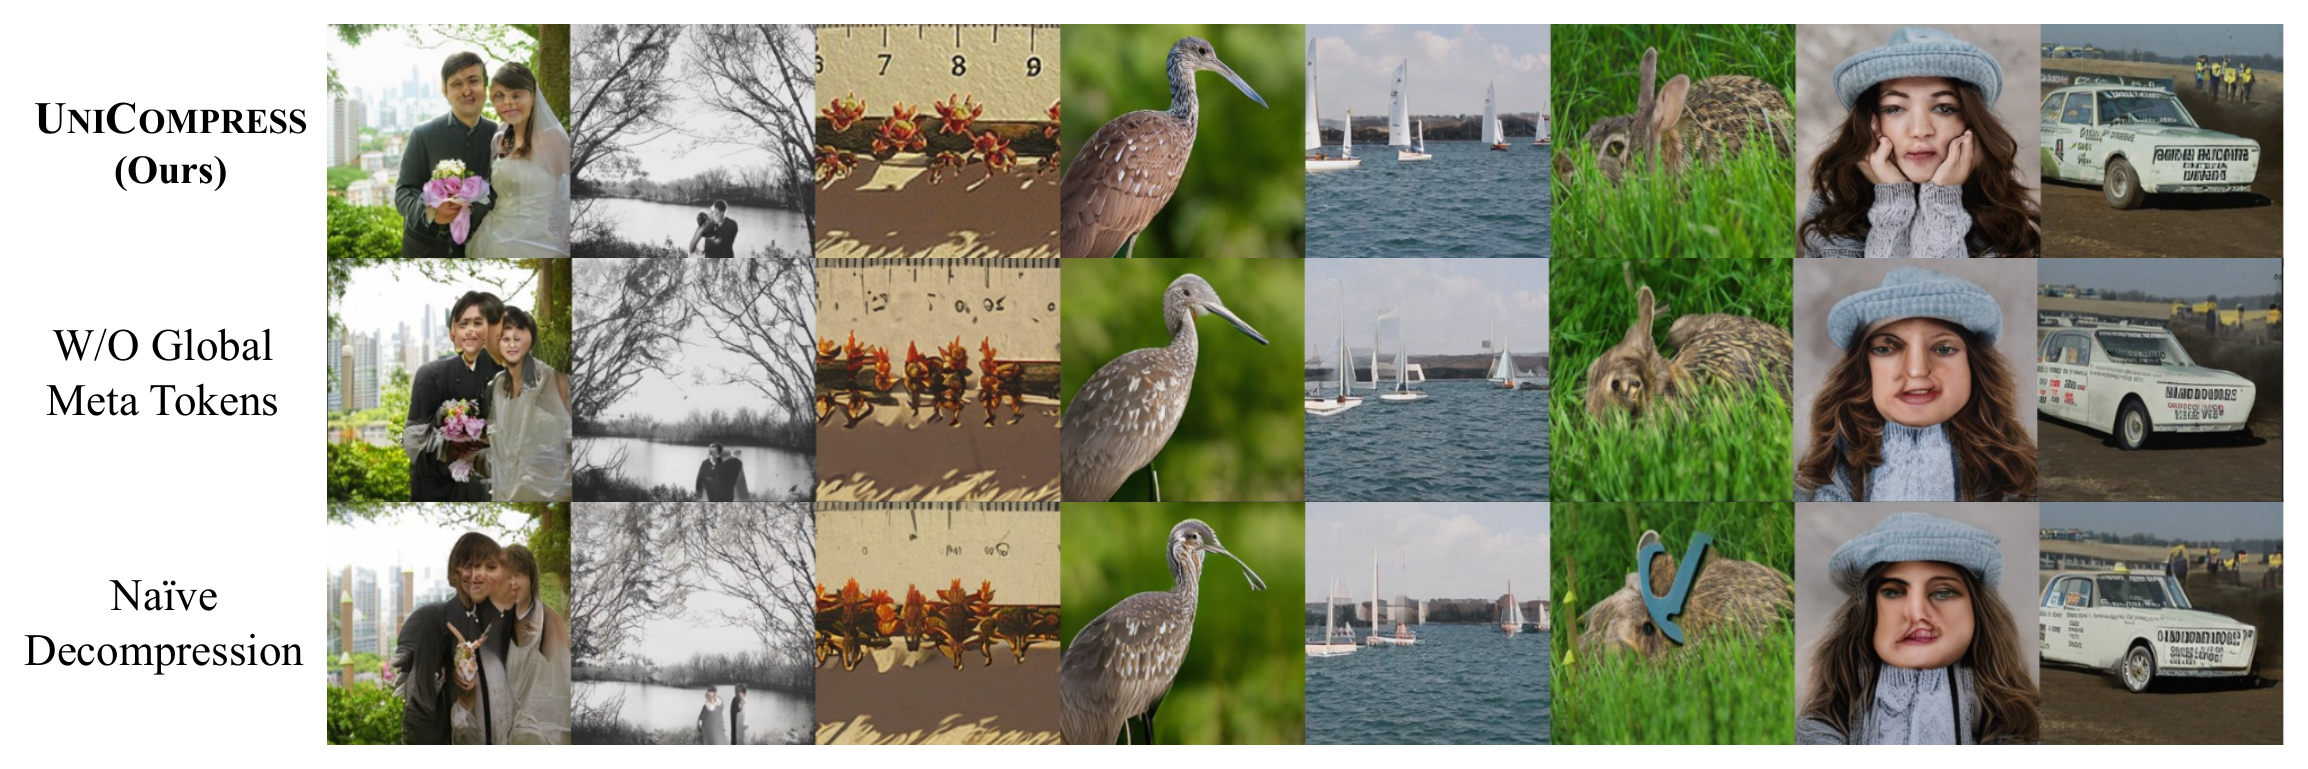
Figure 5는 LLM이 image code를 생성하기 전, tokenizer의 압축·복원 단계 자체를 비교한 것이다. 위에서부터 전체 방법, global meta token 제거, non-autoregressive naive decompression이다.
Global token을 없애면 얼굴과 객체 형태, 장면 구조가 바뀌는 예시가 나타난다. Naive decompression에서는 토끼 주변의 부자연스러운 형태나 얼굴·새의 세부 왜곡이 더 두드러진다. 제안 방법도 완벽히 같은 이미지를 만드는 것은 아니지만, 이 예시에서는 객체와 local detail을 더 잘 유지한다.
이 비교는 global guidance와 autoregressive 복원이 왜 필요한지 보여준다. 다만 정성적 예시이며, 각 모듈의 독립적인 효과를 큰 benchmark의 reconstruction metric으로 모두 분리한 결과는 아니다. Tokenizer가 원본 feature를 잘 복원하는 문제와 LLM이 올바른 compact code를 생성하는 문제도 서로 구분해야 한다.
Conclusion
UniCompress는 UMM의 시각 representation을 소수의 global token과 공간적으로 압축된 local token으로 나눈다. Understanding에서는 이 짧은 feature를 읽고, generation에서는 짧은 code sequence를 생성한 뒤 autoregressive decompressor로 dense feature를 만든다.
핵심 설계는 pooling으로 남기는 coarse local structure, 압축 전 전체 이미지를 읽는 global branch, 학습된 dense reconstruction의 조합이다. 압축한 표현을 두 task에서 재사용하되 각 task에 맞춰 continuous input과 discrete target으로 연결한다.
실험에서는 local token을 256개에서 64개로 줄이고 global 4개를 더했을 때, 여러 모델 계열에서 이해·생성이 가능하고 생성 workload의 시간이 약 41% 감소한다. 동시에 이해 추론의 시간 개선은 작으며, OpenUni의 FID나 BAGEL의 MMMU처럼 성능 저하가 큰 경우도 있다. 효율과 품질의 trade-off는 모델과 task에 따라 다르다.
Limitations
- 정보 손실: average pooling과 quantization은 손실이 있는 변환이다. Global token과 learned decompressor가 이를 보완하지만 원본의 모든 세부정보 보존을 보장하지 않는다.
- 생성 성능의 민감도: 강한 압축에서는 CLIP이 빠르게 낮아진다. 기본 압축률에서도 FID·alignment 손실은 계열마다 다르다.
- 추가 학습과 복원 비용: tokenizer 학습 및 LLM 적응이 필요하다. Decompressor의 규모·단독 시간과 추가 학습까지 포함한 전체 비용은 충분히 보고되지 않는다.
- 구현·비교 범위: diffusion 확장과 loss 세부 설정이 부족하고, 주요 결과는 Llama-3.2-1B의 통제된 variant이다. 원래 공개 checkpoint나 다른 compression 방법 전반에 그대로 일반화하기 어렵다.
- 원문 수치의 불일치: UniTok CLIP의 본문/표 차이와 Table 4 평균값 등은 확인이 필요하다. 이 글은 해당 차이를 명시하고, 각 표 안의 비교를 기준으로 해석했다.
이 논문에서 남길 설계 관점은 LLM이 처리할 시각 정보의 양을 줄이면서도, 생성 decoder가 필요로 하는 dense 표현으로 돌아갈 경로를 함께 설계한다는 것이다. 단순한 token 삭제 이후의 이해 정확도만 보는 것보다, 어떤 정보가 남고 어디서 복원되며 전체 생성 비용이 어떻게 바뀌는지까지 이어서 봐야 한다.